预计算辐照度全局光照(PRTGI)
预计算辐照度全局光照(PRTGI)
实时全局光照是计算机图形学领域的终极问题之一,是渲染高质量、高保真画面的不二法门,也是无数优秀的科学家和工程师绞尽脑汁不断尝试触摸的圣杯。全局光照分为直接光照和间接光照两个部分,直接光照的计算非常简单且有成熟的方案,而间接光照的计算则相对困难。
本篇文章基于预计算辐照度全局光照(PRTGI)从理论到实战进行学习总结,并尝试使用基于VTCode的稀疏八叉树,生成贴着物体表面的探针,并逐探针提取周围可见物体表面的Surfel采样点的 WorldPos,Normal,Albedo和 Skymask。
PRTGI 简介
预计算辐照度全局光照(Precomputed Radiance Transfer Global Illumination)巧妙地将实时光线追踪中的性能瓶颈步骤下放到离线进行求解,能够渲染出 “受限制” 的全局光照结果。通常来说光线追踪通常分为两个步骤:
- 光线与场景求交
- 光照计算
其中光线和场景求交开销之大以至于难以实时运行,光照计算只需要将物体表面属性带入 phong、PBR 等光照模型,相对开销较小。为了规避性能瓶颈,PRTGI 将光线追踪的两个步骤拆分开来:
- 首先 离线 计算光线的传输过程(即光线和场景求交)并保存计算光照所需的法线、位置等必要几何信息
- 在 运行时 读取预计算的场景几何信息并计算实时光照(这一步也叫做 ReLight)
在 lightmap 方案中,光照的传输与计算都发生在离线。而 PRT 的光照计算发生在运行时,这意味着 PRT 带来的 GI 能够实时地响应动态的光源:
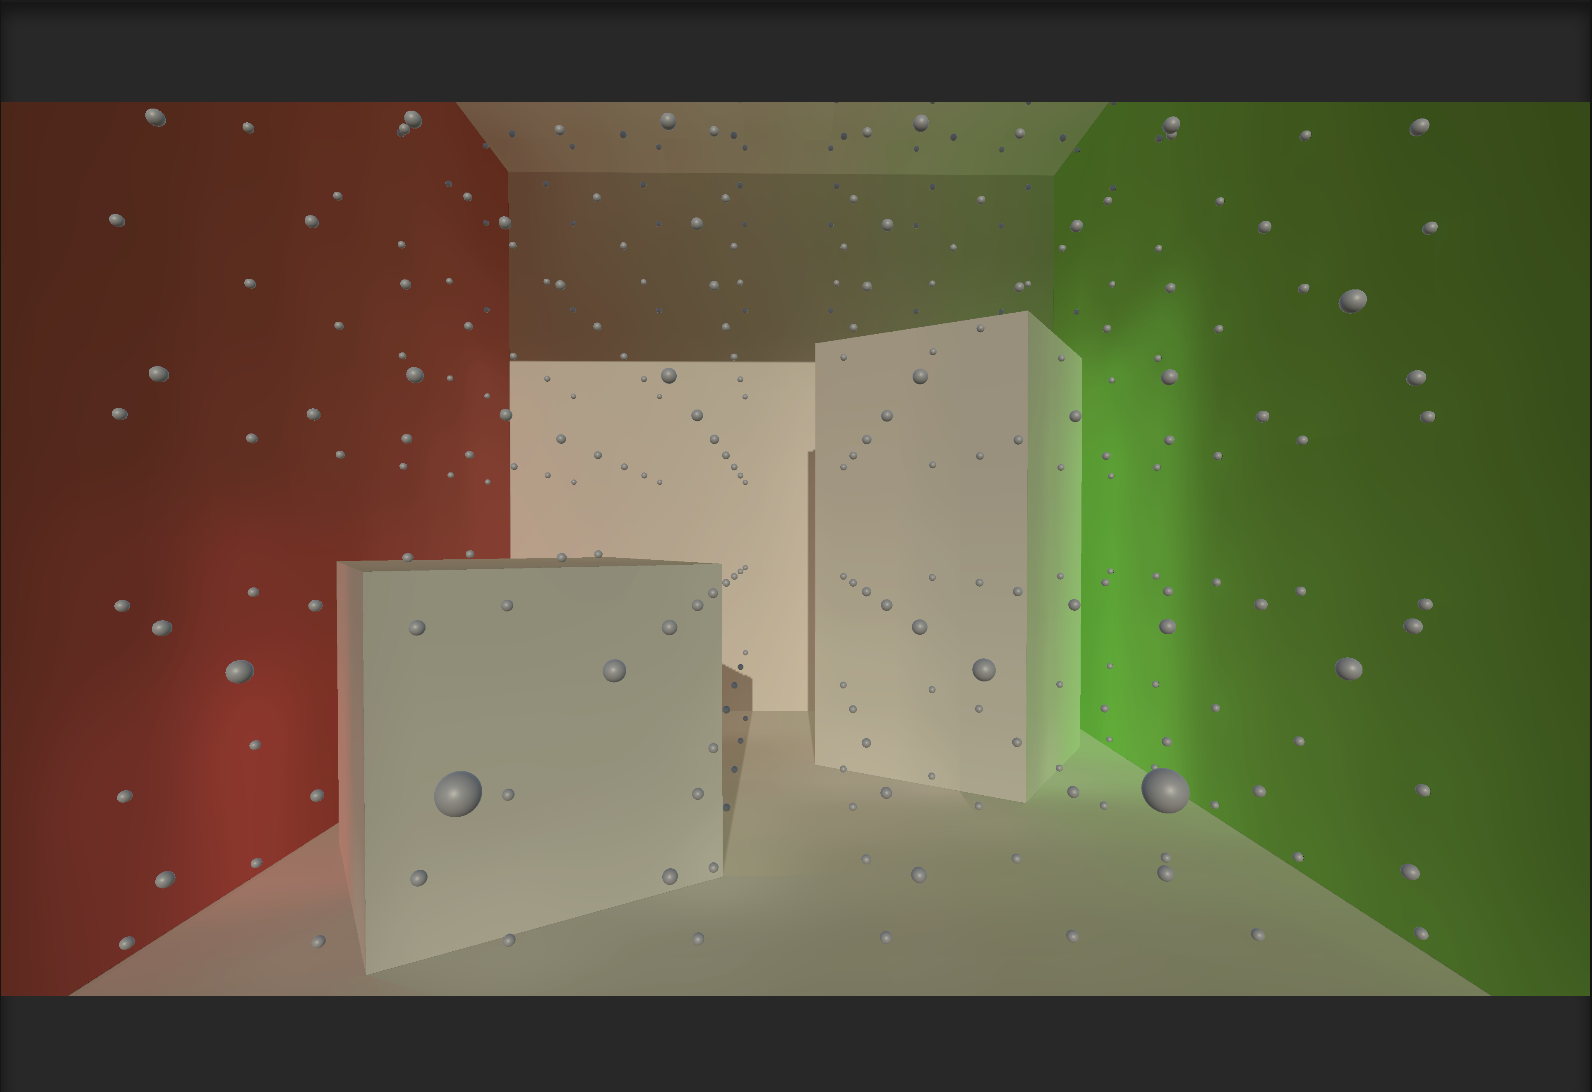
但因为光线传输的过程发生在离线,所以动态物体只能接受 GI 的照明而不能给周围的物体产生 GI 影响,这也是前文提到的 “限制” 之处。
基于VTCode构建稀疏八叉树实现场景划分
在生成Probe之前,需要先建立场景的空间划分。最直接的做法是使用均匀网格,但如果整个场景都采用较小的网格尺寸,就会在大量空旷区域中分配不必要的数据;如果网格太大,又难以区分薄墙、物体边缘和狭窄缝隙。因此,这里使用基于VTCode的稀疏八叉树来组织场景空间,为后续Probe的布置和查询提供基础。
稀疏八叉树与VTCode
八叉树将一个立方体空间递归划分为八个子空间。稀疏八叉树只在需要描述更多几何细节的位置继续细分,空旷区域则保留较大的节点,从而避免完整存储一张高分辨率三维网格。
VTCode用于编码节点的空间坐标和层级。通过这个编码,可以确定节点对应的空间范围,并计算父节点、子节点及相邻节点,方便使用字典等结构组织和查询节点。本工程中使用的是32位编码,最细层为第0层,根节点为第10层。
关于稀疏八叉树的组织方式、VTCode的编码布局与节点寻址,之前已经做过总结,这里不再展开,具体可以参考:稀疏八叉树的编码总结。
场景划分流程
工程中先通过 VTSceneGroup把场景包围盒划分为多个规则的场景块,每个场景块对应一个 VTScene,并拥有独立的稀疏八叉树。场景块用于控制数据的组织粒度,块内的八叉树则用于描述局部几何分布。
每棵树在树空间中覆盖边长为1024的立方体,MinVoxelSize表示一个最小体素对应的世界空间尺寸。因此,单个场景块的世界空间边长为 1024 × MinVoxelSize。世界空间与树空间之间的换算如下,其中 sceneOrigin是当前场景块的最小角点:
treePos  = (worldPos - sceneOrigin) / MinVoxelSize
worldPos = sceneOrigin + treePos * MinVoxelSize
确定场景范围和最小体素尺寸后,离线划分主要包含以下几个步骤:
- 收集场景几何。 将参与划分的网格三角形转换到世界空间,作为构建八叉树的输入。
- 逐块处理三角形。 将三角形转换到当前场景块的树空间,跳过与根节点包围盒不相交的三角形。
- 递归细分相交区域。 对三角形与子节点包围盒进行相交测试,只沿相交的分支继续细分,直到最小体素层级;没有几何穿过的区域保持较粗的空间划分。
- 记录节点状态。 区分需要继续展开的节点、被几何占据的叶子区域,以及没有检测到几何相交的空闲区域,供后续遍历和空间查询使用。
需要注意,这里的占据标记来自三角形与体素的相交关系。一个体素被标记为Block,并不代表整个体素都处于物体内部;没有与三角形相交,也不等于一定处于物体外部。 例如,封闭物体内部的某个体素可能完全没有表面三角形穿过。因此,后续生成Probe时,还需要结合原始几何检查采样位置,不能只依据粗层级的节点状态判断探针是否有效。
保存划分结果
划分完成后,将场景组织信息与各场景块的数据分别保存:
.vtgroup:记录场景包围盒、分块数量和最小体素尺寸。.vtscene:保存单个场景块的八叉树数据,文件名中包含该块的三维索引。
这样便可以按场景块组织和读取数据,而不必每次重新进行完整的几何划分。这个阶段得到的是空间结构,还没有生成探针或计算光照。下一步会在这一空间组织基础上,结合表面和狭缝的分布进行局部细化,再生成有效的Probe采样位置。
Probe的生成
完成场景划分后,就可以在空间中布置Probe。Probe可以理解为光照场中的一个采样位置:离线阶段从这个位置采集周围可见表面的Surfel,运行时再根据这些Surfel计算入射光照,并将结果保存为球谐系数。物体着色时,通过周围探针重建当前位置接收到的间接光照。
这里沿用上一章的场景分块、坐标原点、体素尺度和VTCode寻址方式,但Probe生成阶段会结合当前场景的原始网格,重新构建一棵光照用的自适应八叉树。这样可以按光照采样的需要控制密度,同时避免直接把已经粗化的Block状态当作精确的几何信息。
1. Probe在稀疏八叉树结构中的布置
从叶子体素的八个角点开始
本实现以叶子体素的八个角点作为Probe的候选位置,而不是在每个体素中心放置一个Probe。对于边长为 D、最小角点为 cell.min的叶子体素,八个候选点可以由三个取值为0或1的偏移量表示:
// 角点顺序:bit0 = X,bit1 = Z,bit2 = Y。
Vector3 offset = new Vector3(i & 1, (i >> 2) & 1, (i >> 1) & 1);
Vector3 logicalPosition = cell.min + Vector3.Scale(offset, cell.size);
其中 i的范围为0~7。这个顺序与 GpuOctreeNode中的 probeIndex0~probeIndex7保持一致,便于后续按X、Y、Z三个方向计算三线性插值权重。需要区分的是,0~7是当前叶子的角点槽位,而 probeIndex是探针在整个分块数组中的索引。
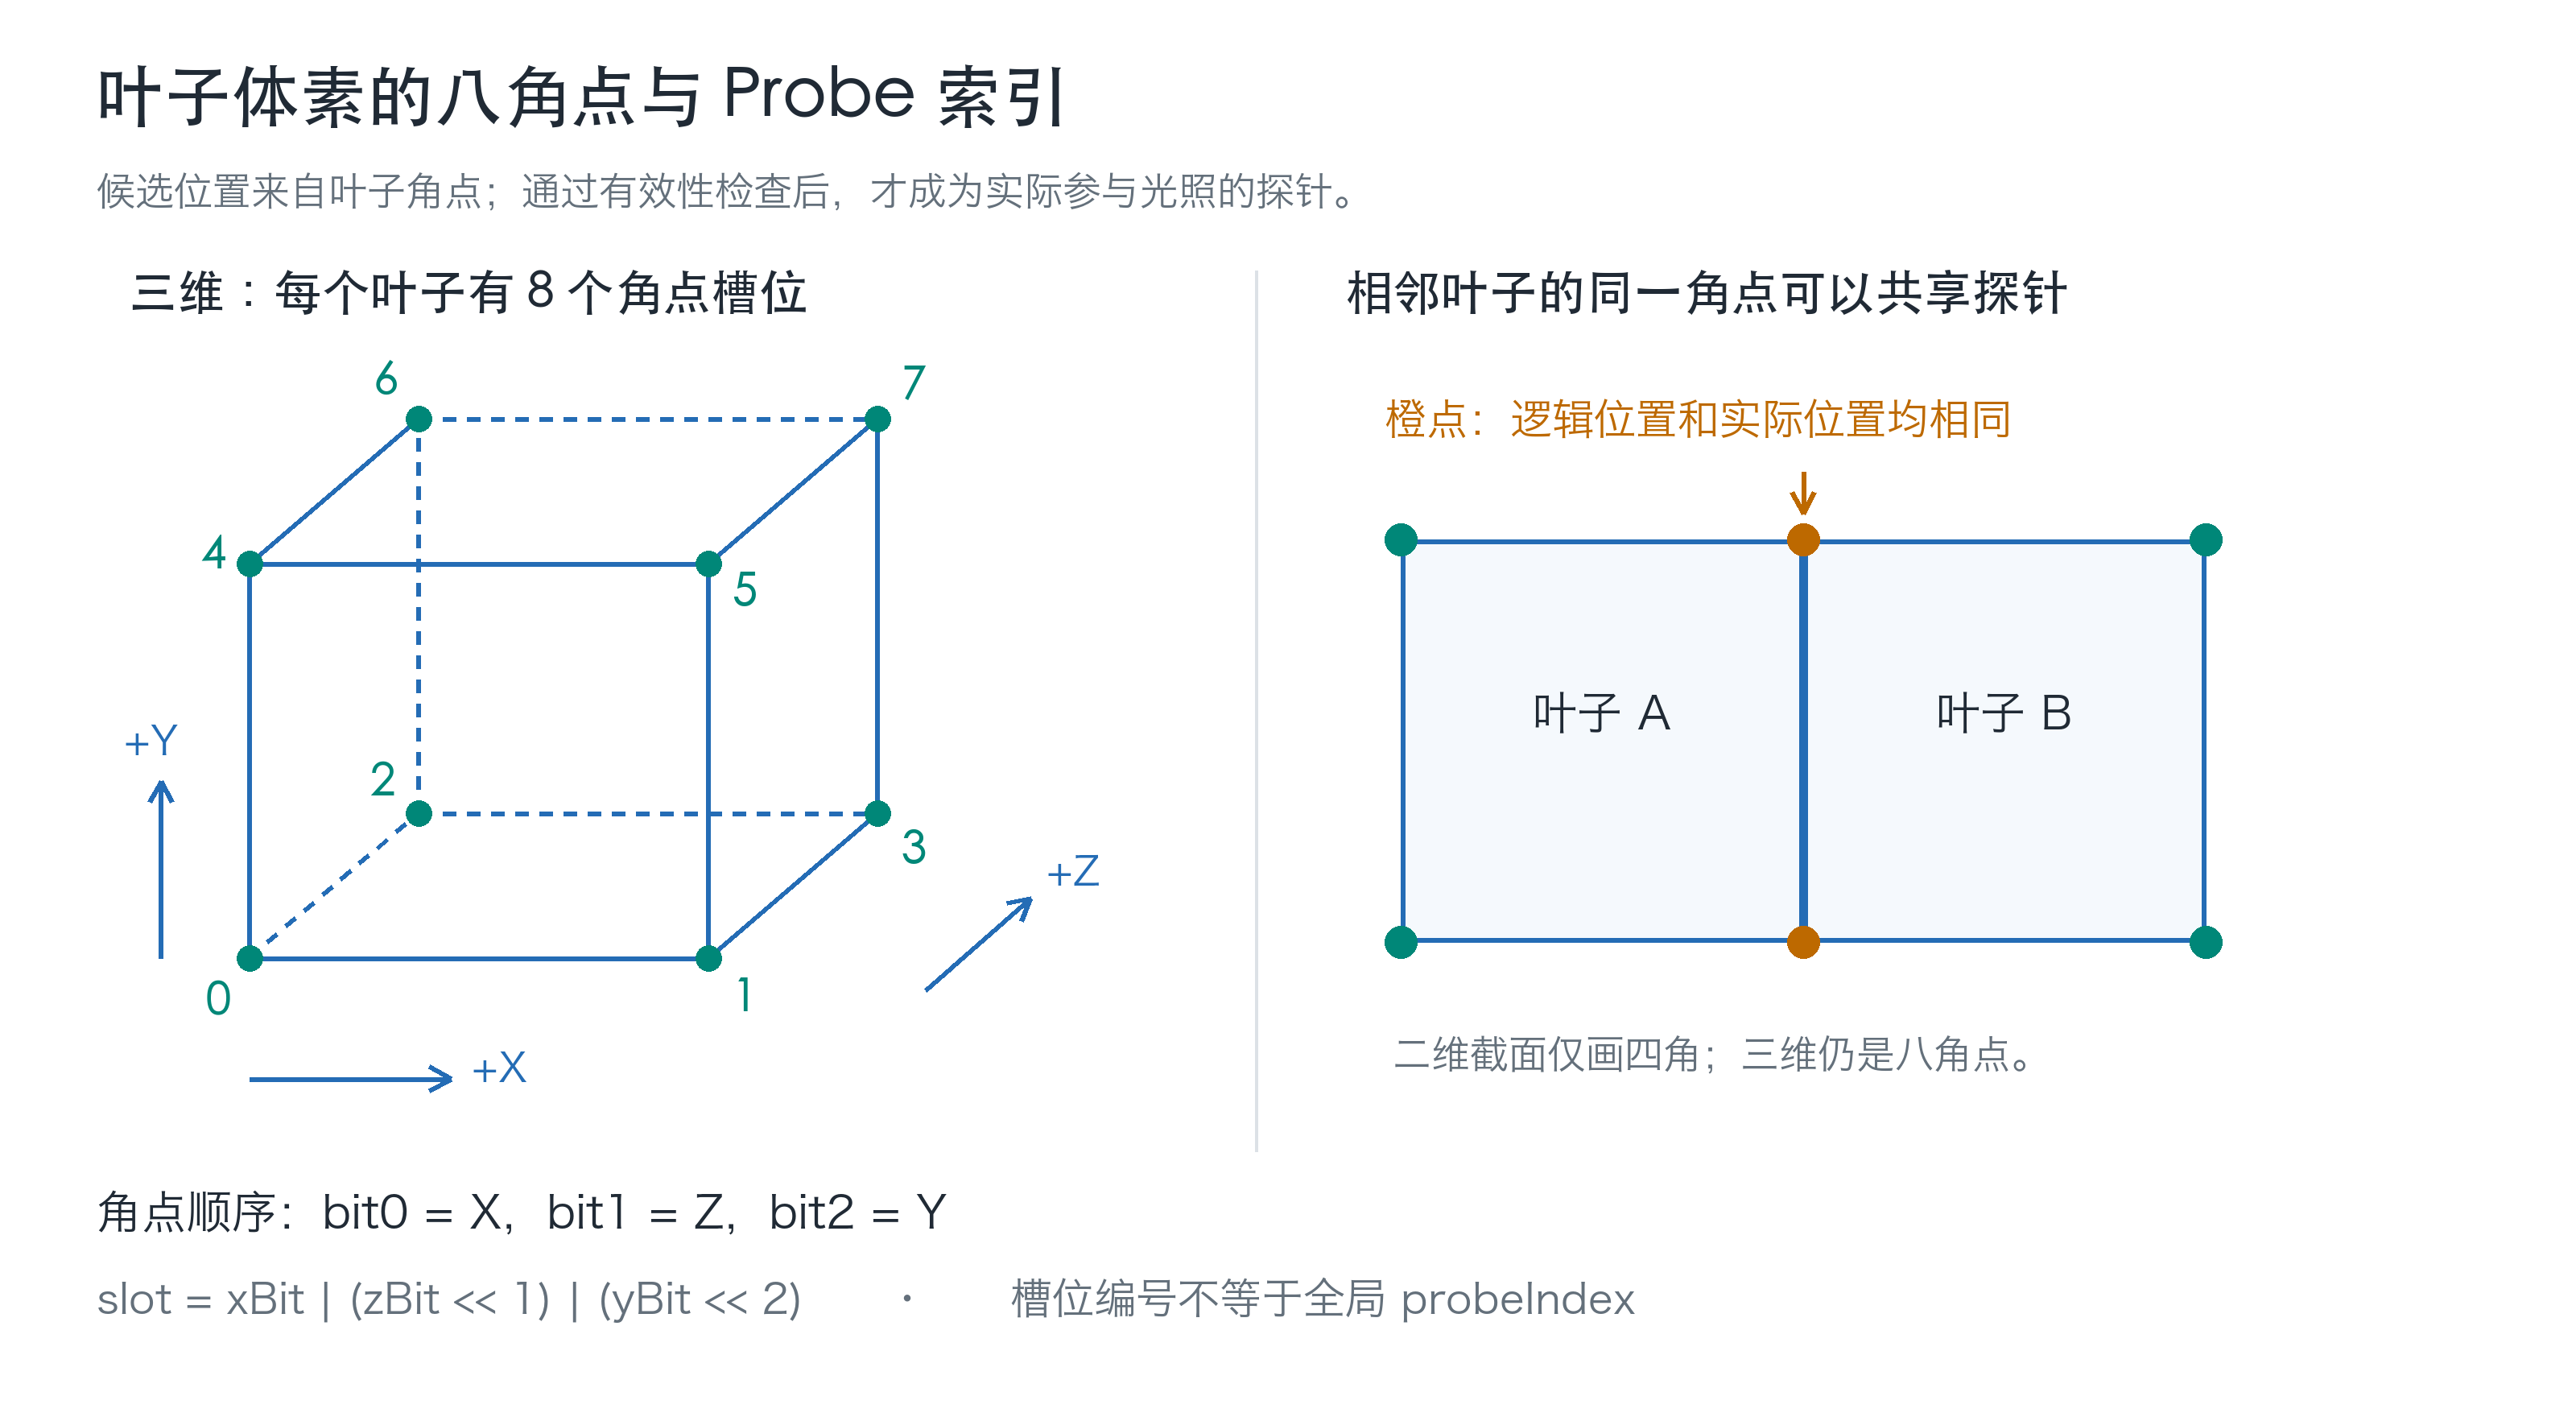
图:左侧为三维角点编号;右侧用二维截面表示相邻叶子对同一探针的引用。
相邻叶子可能拥有相同的角点,因此不能简单地为每个叶子固定创建八个独立探针。生成过程中会对探针进行去重,再把最终索引写回各叶子的角点槽位。这样,一个有效探针就可以同时服务于多个相邻叶子。
逻辑角点与实际采样位置
角点只是候选位置,它可能位于墙体内部,或者距离表面太近。因此,每个Probe需要区分两种位置:
| 位置 | 含义 | 用途 |
|---|---|---|
logicalPosition |
原始叶子体素的角点位置 | 保留角点与叶子的对应关系;基础插值权重仍由逻辑体素坐标计算 |
position |
通过有效性检查后的实际位置 | 烘焙Surfel,以及计算探针方向与可见性 |
没有发生位置修正时,两者相同。发生修正后,探针仍占据原来的逻辑角点槽位,但从新的实际位置采集周围表面。只有逻辑位置与实际位置都相同的探针才会合并;如果相邻体素需要把同一逻辑角点移到不同位置,就保留两个探针及各自的引用。
按场景几何控制密度
并不是所有区域都需要相同大小的叶子。开阔空间可以保留较大的节点,普通表面附近按 SurfaceLayer细分,两个物体邻近的区域则按 NarrowGapLayer进一步细化。
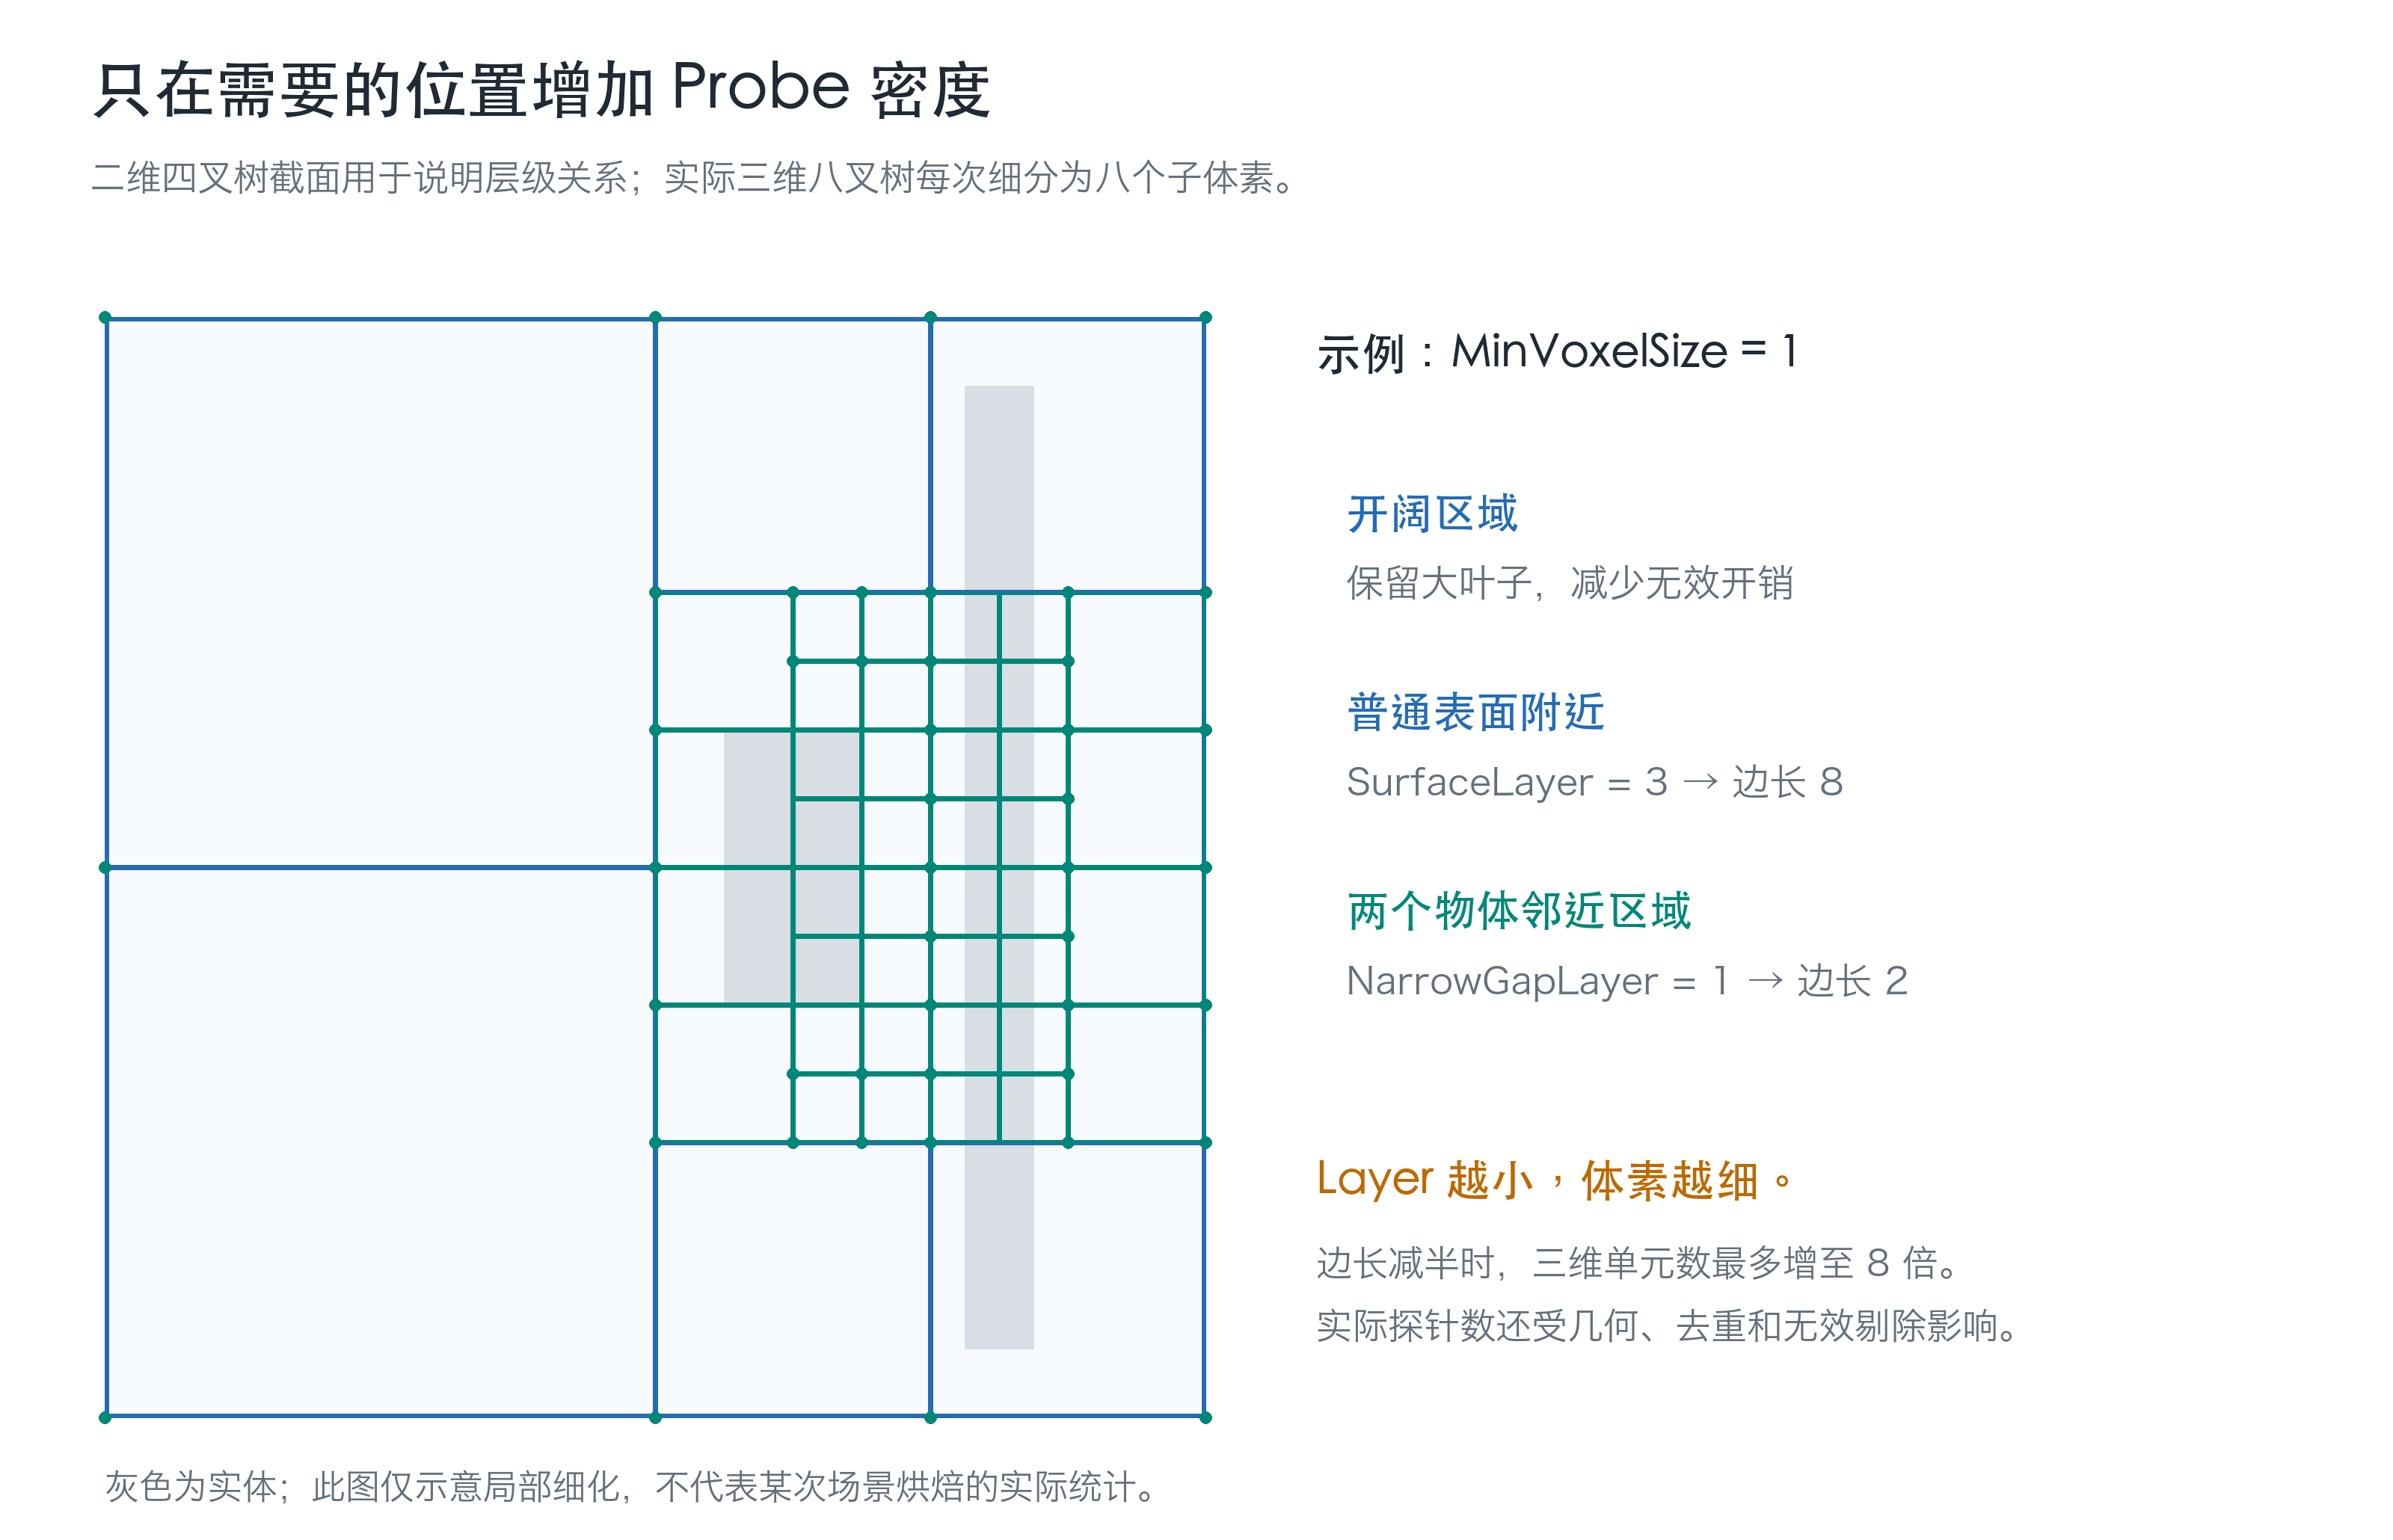
图:相同场景范围内,只在几何关系复杂的位置增加细小体素。实际三维细分与二维示意的数量增长不同。
当前对“狭缝”的识别采用一个简单的启发式:**扩大待检查体素的包围盒,判断其中是否接触到至少两个不同网格实例的表面。满足条件时采用更细的目标层级。**这并不是精确测量缝隙宽度,也不会自动识别同一网格内部的所有凹槽,但能够覆盖本例中墙面与方块相互邻近的情况。
2. 被场景覆盖的体素的处理策略
先区分表面相交与实体内部
上一章的占据标记描述的是三角形与体素的相交关系,不能直接用于判断一个点是否位于实体内部。在递归细分达到目标层级、准备放置探针时,还需要结合原始几何区分以下情况:
| 体素情况 | 判断与处理 |
|---|---|
| 空闲区域 | 没有表面穿过,中心也在实体外。继续检查八个候选角点是否满足表面间距要求,通过的角点可以保留原位置 |
| 表面穿过体素 | 按表面或邻近区域的目标层级细分,再逐角点检查;落在实体内或过于贴近表面的候选点需要位置修正 |
| 完全处于实体内部 | 没有表面穿过,而且中心在实体内。该叶子不生成有效探针,八个角点槽位保持无效 |
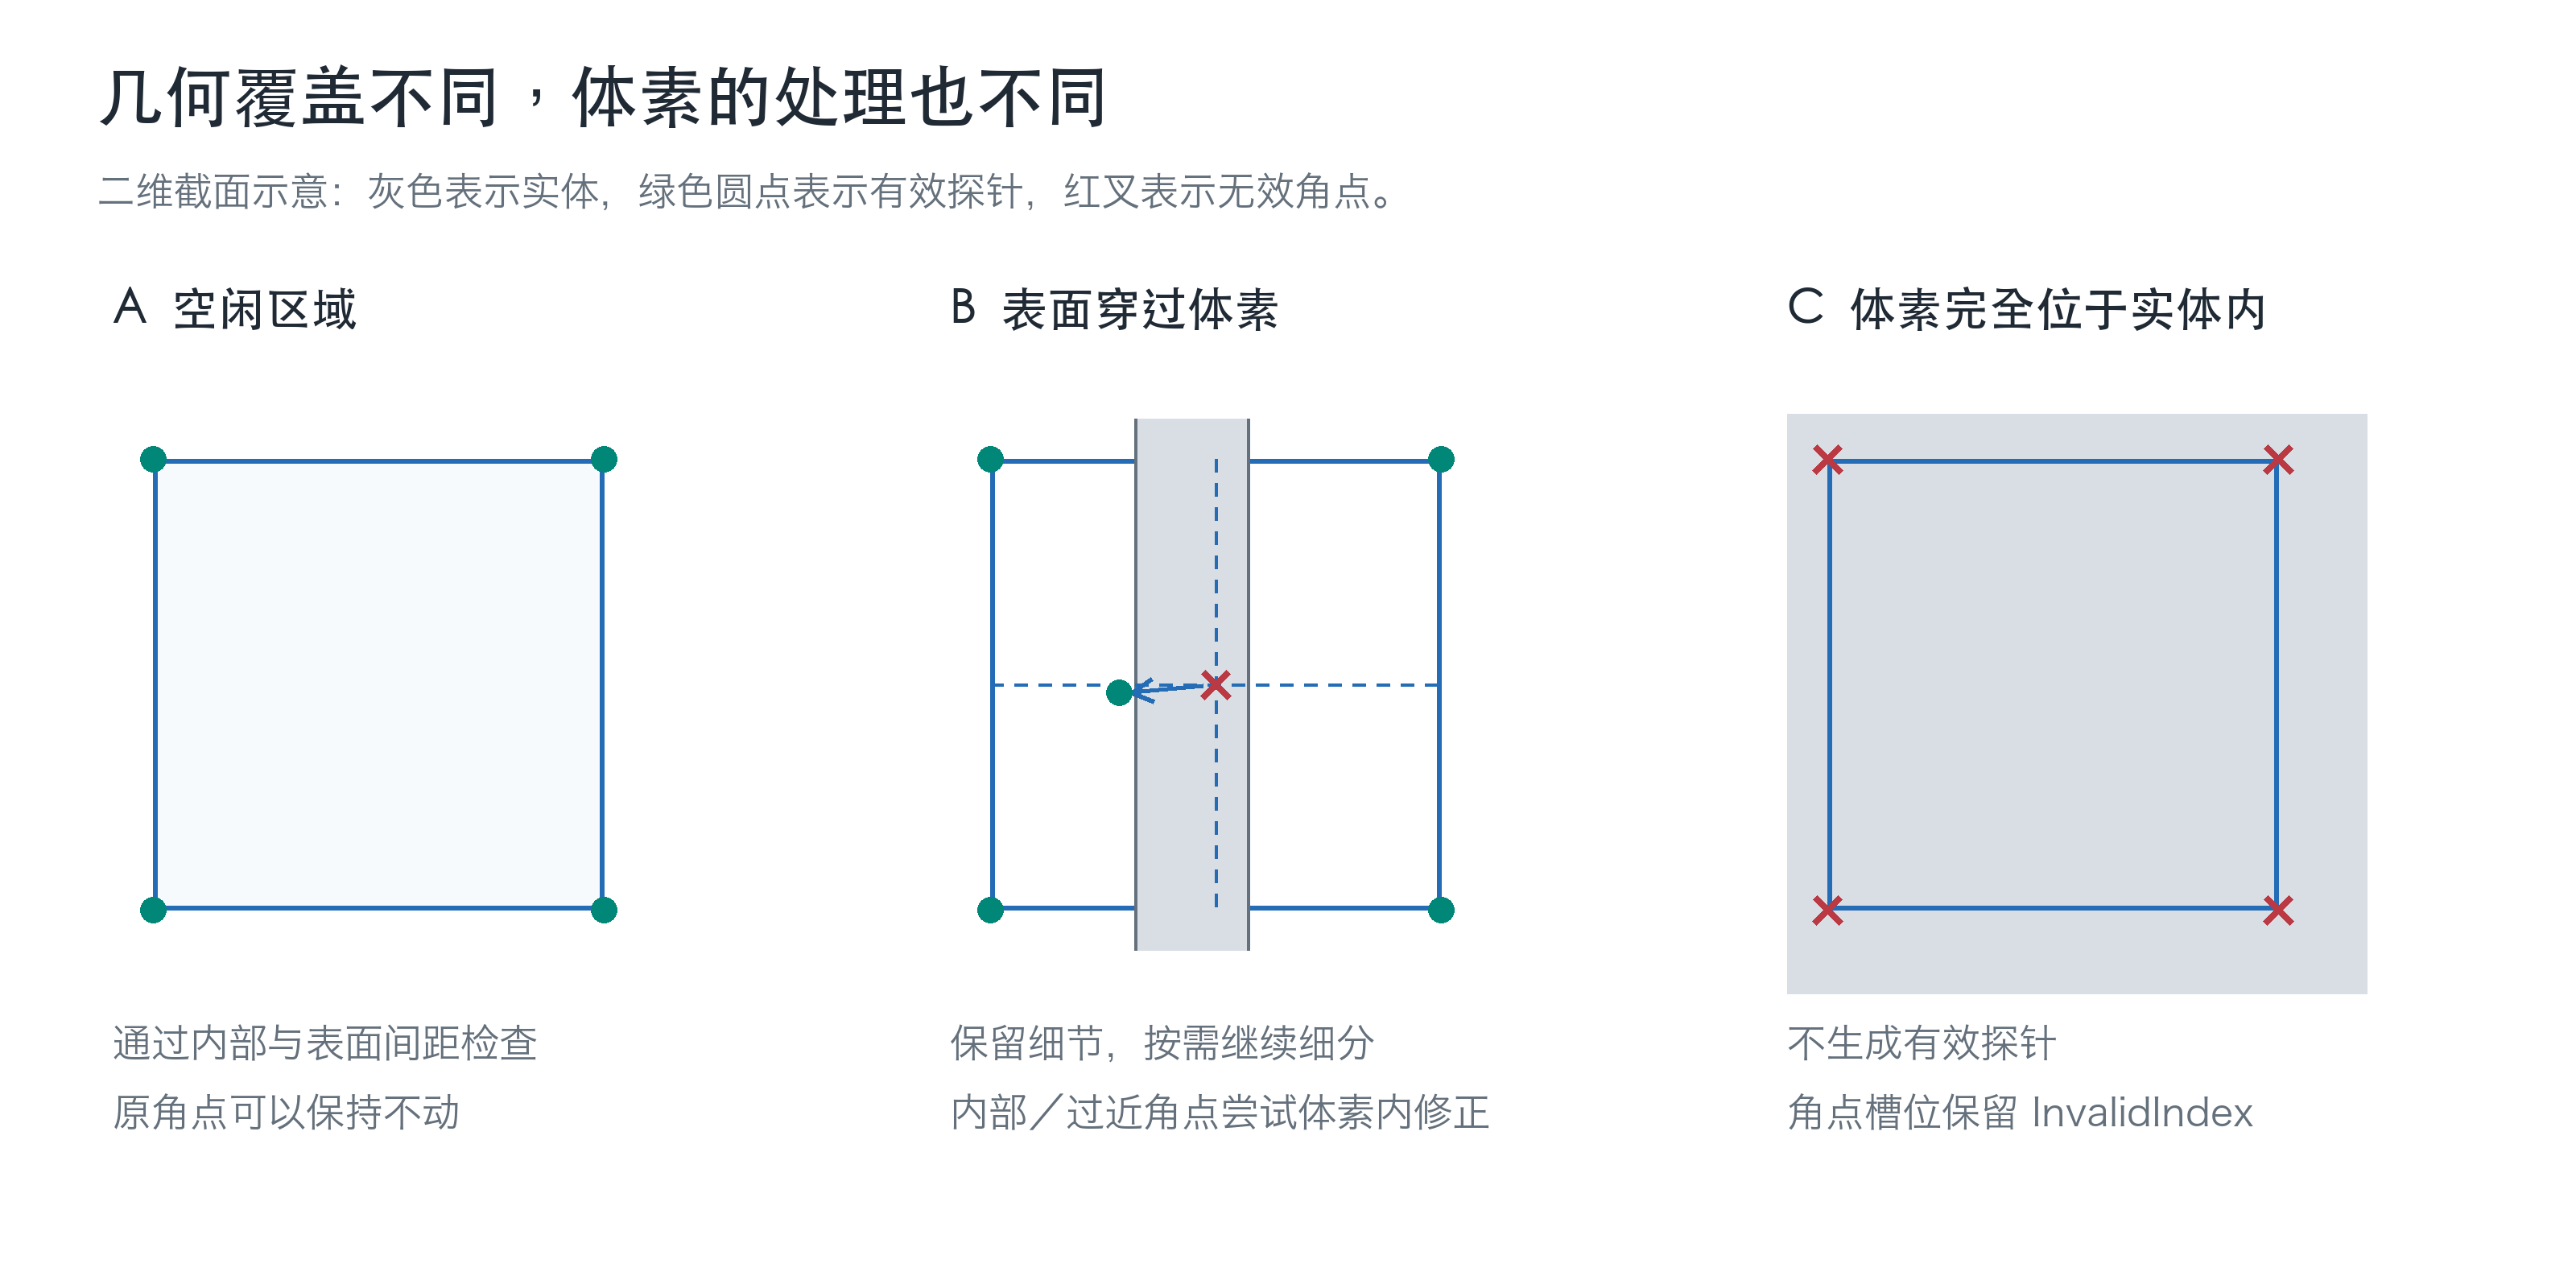
图:一个体素与表面相交,并不意味着它的所有角点都无效;完全位于实体内部的体素则不需要放置光照采样点。
当前使用按网格实例分别统计的射线求交奇偶性判断内部,并通过点到三角形的距离检查表面间距;查询由三角形BVH加速。这种内部判定以封闭网格为前提,开口或非流形网格需要额外的内外侧规则。
在所属体素内修正无效角点
如果候选角点本来就在实体外,并且与几何表面的距离不小于 SurfaceClearance,就直接使用它,允许它保持在原来的体素边界上。只有未通过检查的角点,才进入位置修正流程。
修正后的实际位置必须同时满足:
- 位于所属体素内部,并与体素边界保留一个小的内缩距离。
- 到原逻辑角点的欧氏距离不超过
D × MaxRelocationFraction,其中D是所属体素的边长。 - 位于场景实体之外,而且与几何表面的距离不小于
SurfaceClearance。
例如,体素边长为2,MaxRelocationFraction=0.45时,最大位移上限为0.9个世界单位。这是整体位移长度的上限,不是允许X、Y、Z各自独立移动0.9。
实现中会沿角点朝体素内部的方向组合出最多64个离散候选位置,先过滤越界或超过位移上限的点,再按到原角点的距离由近到远检查,选取第一个有效位置。因此,这是一种受约束的离散搜索,并不保证找到连续空间中距离最近的可行位置。
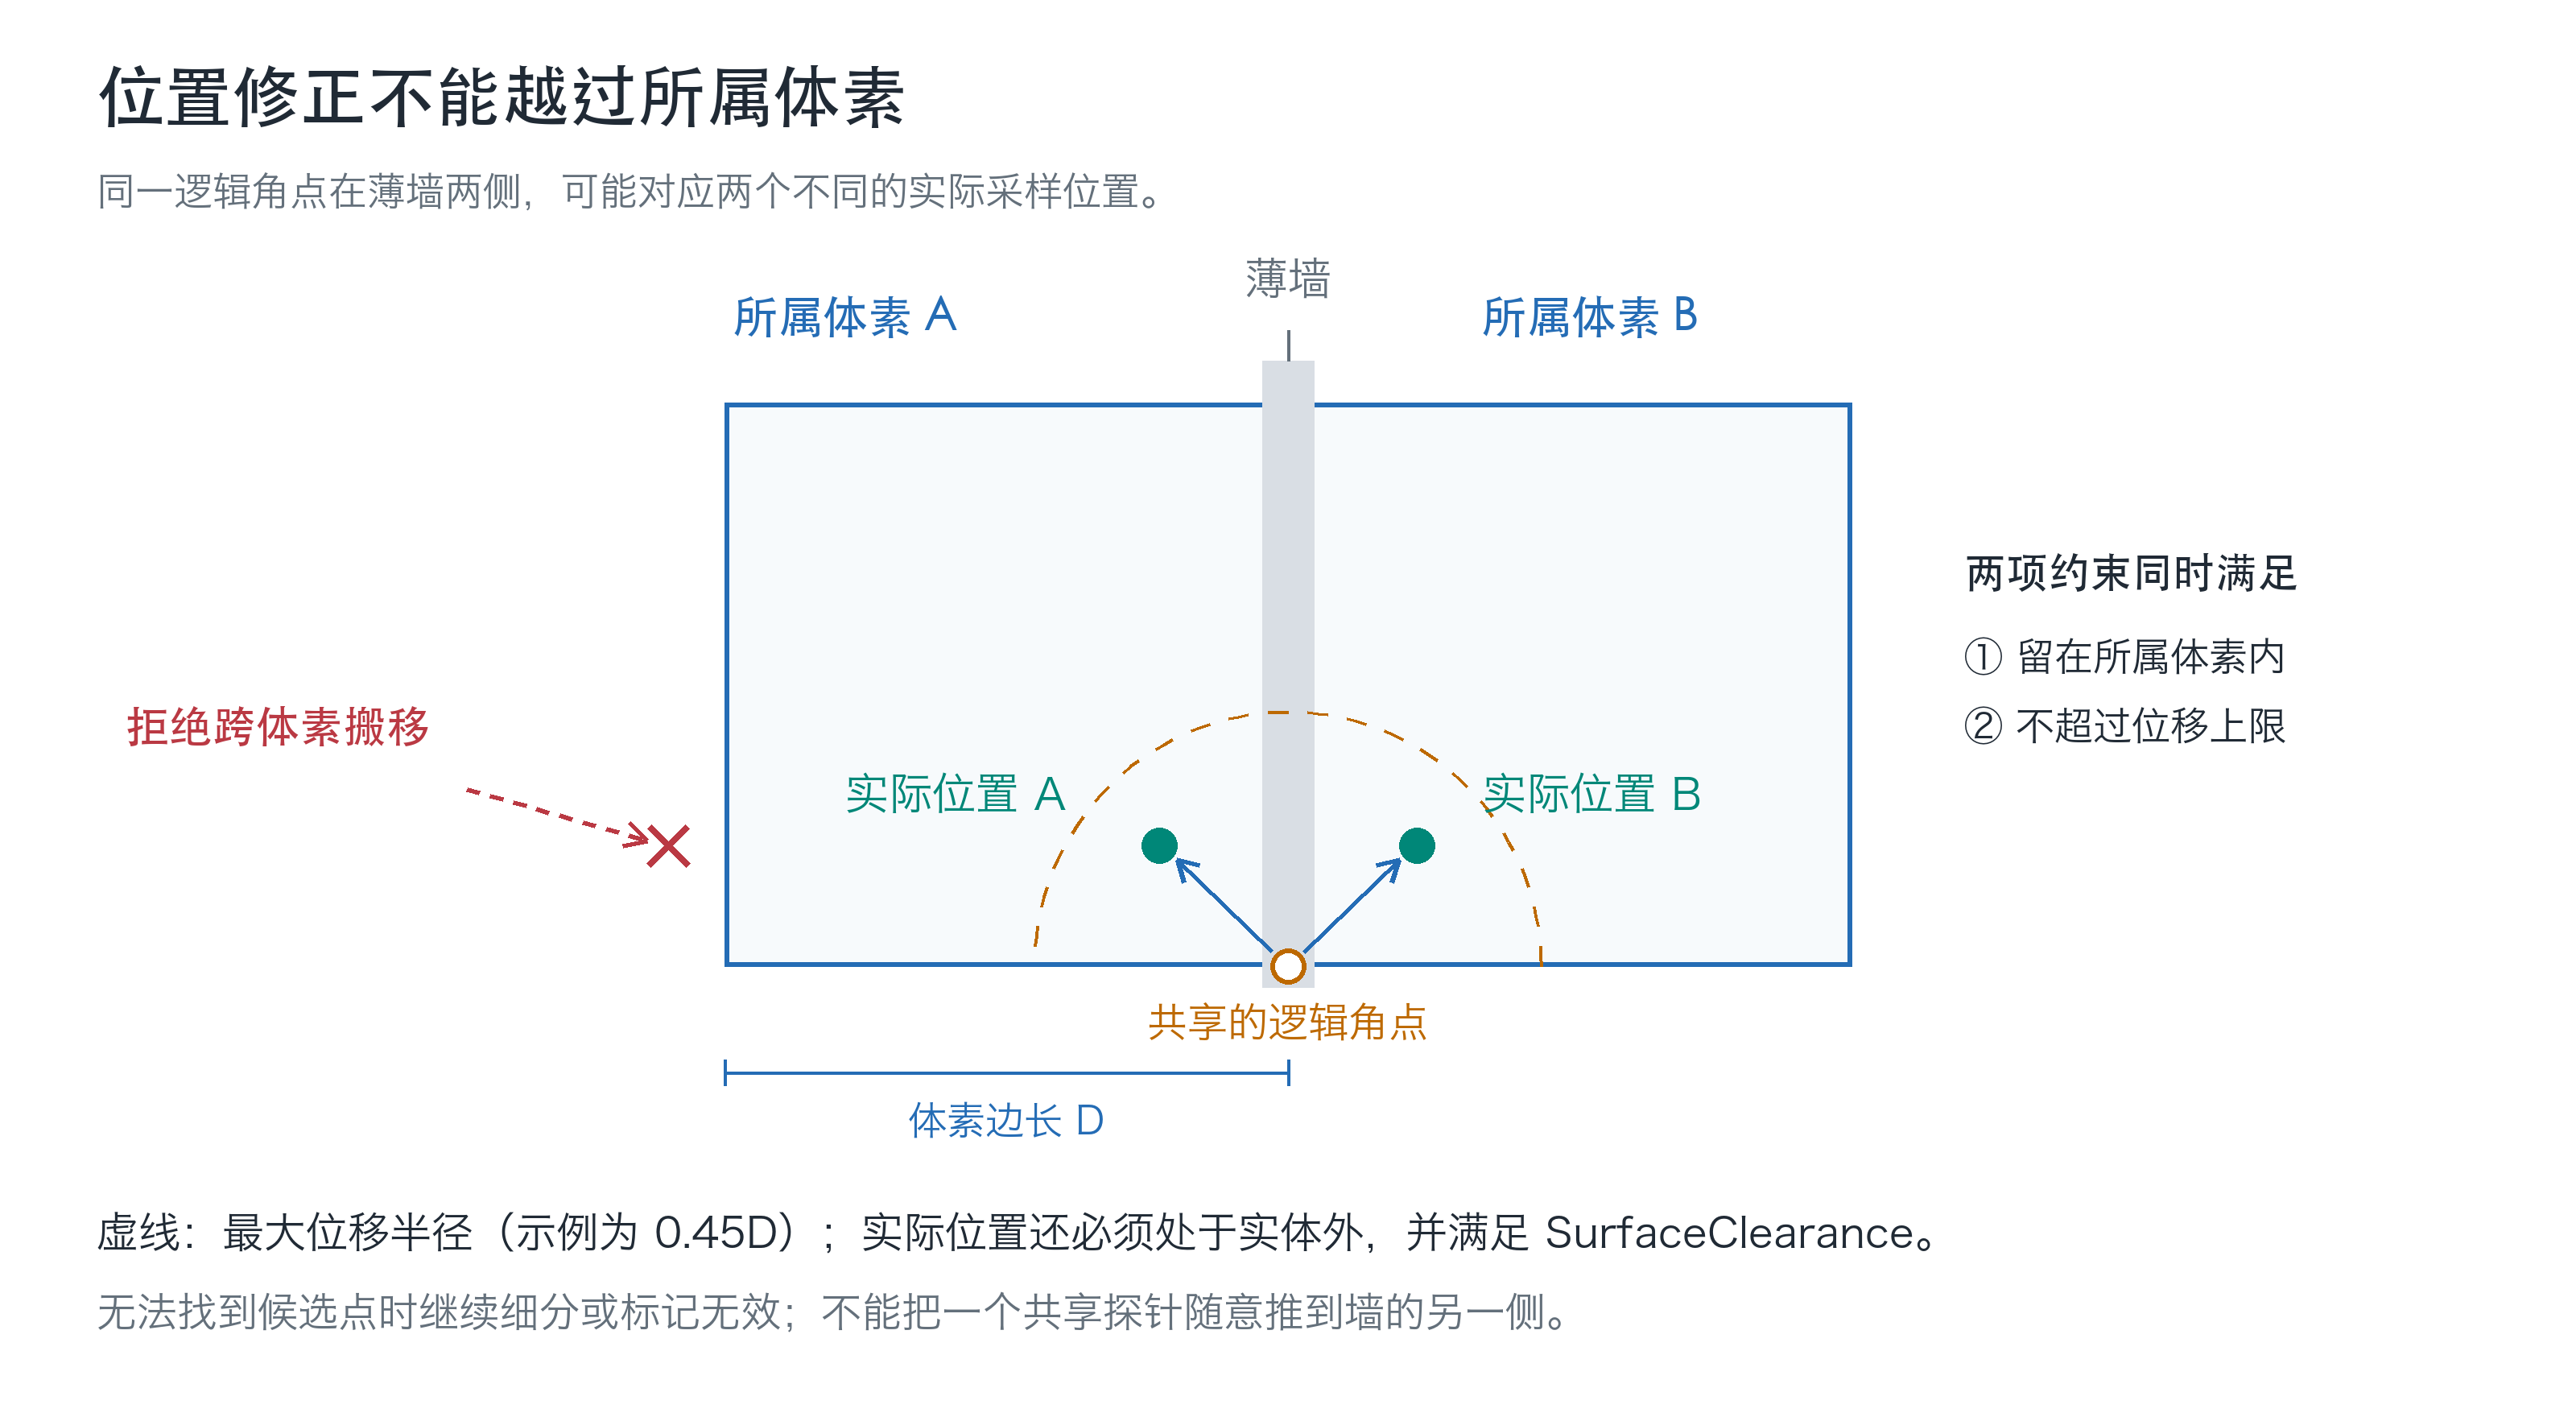
图:薄墙两侧可以拥有相同的逻辑角点,但不能为了寻找自由空间而把探针移出各自所属的体素。
这条约束很重要。如果把室内侧的探针直接推到墙外,它采集到的可能是室外天空光,即使位置已经不在实体内部,也不适合代表室内侧的光照。
找不到有效位置时怎么办
如果某个叶子并非完全位于实体内,但八个角点都找不到有效候选位置,而且还没有达到允许的最细层级,就继续细分,再尝试为子体素生成Probe。如果已经达到细分下限,就保留无效角点槽位,不能通过越界搬移来凑足八个探针。
对于只有部分角点无效的叶子,当前实现会保留有效角点,并将失败的槽位设为 InvalidIndex,即 uint.MaxValue。这些无效槽位不对应实际探针,不采集Surfel,运行时插值也会跳过它们。之后保存与加载数据时,还会检查逻辑角点、实际位置、体素归属和位移上限,避免错误的映射进入GPU。
需要注意,探针处于自由空间,并不代表它与每个着色点之间都无遮挡。实际采样时仍需要额外检查可见性,防止使用墙另一侧或其他物体背后的探针。位置有效性负责“探针能不能放在这里”,可见性负责“这个着色点能不能使用它”,两者都不可缺少。
3. 生成Probe时各个参数的含义
层级参数首先要结合体素尺度理解。设最小体素的世界空间边长为 MinVoxelSize,第 L层体素的边长为:
这里的Layer不是从根节点向下计数的深度:Layer越小,体素越细;Layer越大,体素越粗。 例如 MinVoxelSize=1时,第1、3、4层的边长分别为2、8、16。
下表中的默认值是当前源码初始值,Inspector中已经保存的设置可能与之不同。
| 参数 | 默认值 | 含义及调整影响 |
|---|---|---|
MinLayer |
7 | 参与限制普通表面的目标层级。它不要求整棵树的所有叶子都停在同一层,实际值还会与 SurfaceLayer取较小者 |
VTGroupFilePath |
未设置 | 指向上一阶段生成的 .vtgroup,读取分块信息、坐标原点与体素尺度。Probe布局仍会结合当前场景网格生成 |
SurfelSampleCount |
512 | 每个有效Probe采集的Surfel数量。影响光照投影的采样误差、存储量和Relight开销,不直接改变探针的空间密度 |
SurfaceLayer |
3 | 与几何表面相交区域的目标层级。数值越小,表面附近通常越密集 |
NarrowGapLayer |
1 | 两个不同网格实例邻近区域的目标层级。实际生效值不会比有效的表面层级更粗 |
SurfaceClearance |
0.05 | 探针实际位置到几何表面的最小距离,单位为世界单位。过大可能使狭小空间中难以找到有效位置 |
MaxRelocationFraction |
0.45 | 最大位移与所属体素边长的比例。即使仍在位移半径内,只要候选点越过体素边界,也会被拒绝 |
MaxProbeCount |
65536 | 每个分块允许生成的有效Probe数量上限。超过时中止生成并报错,不会自动降低密度,也不是每帧Relight的更新预算 |
SpawnProbeMarkers |
开启 | 是否为生成的Probe创建可视化球体。只影响布局查看,不决定GI数据是否有效;大量球体本身会产生额外渲染开销 |
MinVoxelSize来自场景划分数据,并不是这里单独设置的生成参数。它会影响同一Layer对应的实际尺寸,因此比较两次烘焙的密度时,不能只比较Layer数值。
三个层级参数的实际关系为:
int surfaceLayer = Mathf.Min(MinLayer, SurfaceLayer);
int gapLayer = Mathf.Min(surfaceLayer, NarrowGapLayer);
例如,MinLayer=6、SurfaceLayer=4、NarrowGapLayer=5时,两类区域的有效目标层级都是4;若 MinVoxelSize=1,对应边长都是16,狭缝区域并没有得到更细的划分。把 NarrowGapLayer改为1,才会让识别出的邻近区域继续细化到边长2。
另外,gapLayer还参与邻近区域的判定范围:当前实现将查询包围盒向每侧扩展 MinVoxelSize × 2^gapLayer后,再统计附近的网格表面。因此,它既影响细化目标,也会影响哪些区域被识别为需要细化的邻近区域。
调整参数时,可以先确定 MinVoxelSize和普通表面的目标层级,再针对墙角、物体接触处降低 NarrowGapLayer。同时观察生成的有效探针数量与无效角点数量,避免一开始就把整个表面区域划分得过细。三维体素的边长每减半,同一区域的单元数最多会增至8倍;实际探针数量还受到角点共享、位置修正和无效剔除的影响。
最后,Generate Probes只生成并保存探针布局,Surfel数组仍为空;GenerateProbe and Surfel才会继续完成逐探针采集。改变布局参数后需要重新生成并采集,单独改变 SurfelSampleCount也需要重新采集才能生效。下一节将介绍如何从每个有效Probe的位置提取周围可见表面的数据。
逐Probe的Surfel提取
上一节得到了一组有效的Probe位置。接下来要回答的问题是:站在某个Probe的位置,沿不同方向观察,最先看到的是什么表面?这个表面的位置、法线和反射率分别是多少?
本实现通过Cubemap记录这些信息,再由Compute Shader从中提取固定数量的方向样本。最终保存的是几何与材质属性,光源颜色、阴影和间接光照则留到运行时的Relight阶段计算。
1. 一个Surfel需要记录什么
Surfel可以理解为一个表面采样记录。在这里,它不是一个完整的三角形,也没有显式保存圆盘半径或面积,而是保存某个采样方向对应的可见表面属性:
| 字段 | 含义 | 后续用途 |
|---|---|---|
position |
可见表面的世界空间位置 | 计算Probe指向该表面的方向,以及查询表面处的光照和阴影 |
normal |
该表面的世界空间单位法线 | 计算表面接收的直接光和历史间接光 |
albedo |
表面的RGB漫反射反射率 | 将接收到的辐照度转换为表面反射出的Radiance |
skyMask |
当前方向是否未命中几何 | 区分表面反射光与天空入射光 |
如果一个方向没有看到几何,也会保留一条记录,并令\mathrm{skyMask}=1。因此,一个Probe的N条记录中,既可能包含真实表面样本,也可能包含天空方向样本,并不意味着一定找到了N个不同的表面点。
2. 在Probe位置采集三份Cubemap
我们在Probe的实际采样位置放置一台临时相机,分别向+X、-X、+Y、-Y、+Z、-Z六个方向渲染。Cubemap把六个面组织为一个方向查询结构,之后只要给出一个三维方向,就可以读取对应的纹素。
与普通场景渲染不同,这台相机不输出最终光照颜色,而是依次使用三个属性Shader,生成三份GBuffer Cubemap:
| Cubemap | 记录内容 | 当前格式 |
|---|---|---|
| WorldPos | RGB记录世界空间位置 | ARGBFloat |
| Normal | RGB记录世界空间法线,Alpha记录是否命中表面 | ARGBHalf |
| Albedo | 记录基础纹理与基础颜色逐分量相乘得到的表面颜色,提取时使用RGB | ARGB32 |
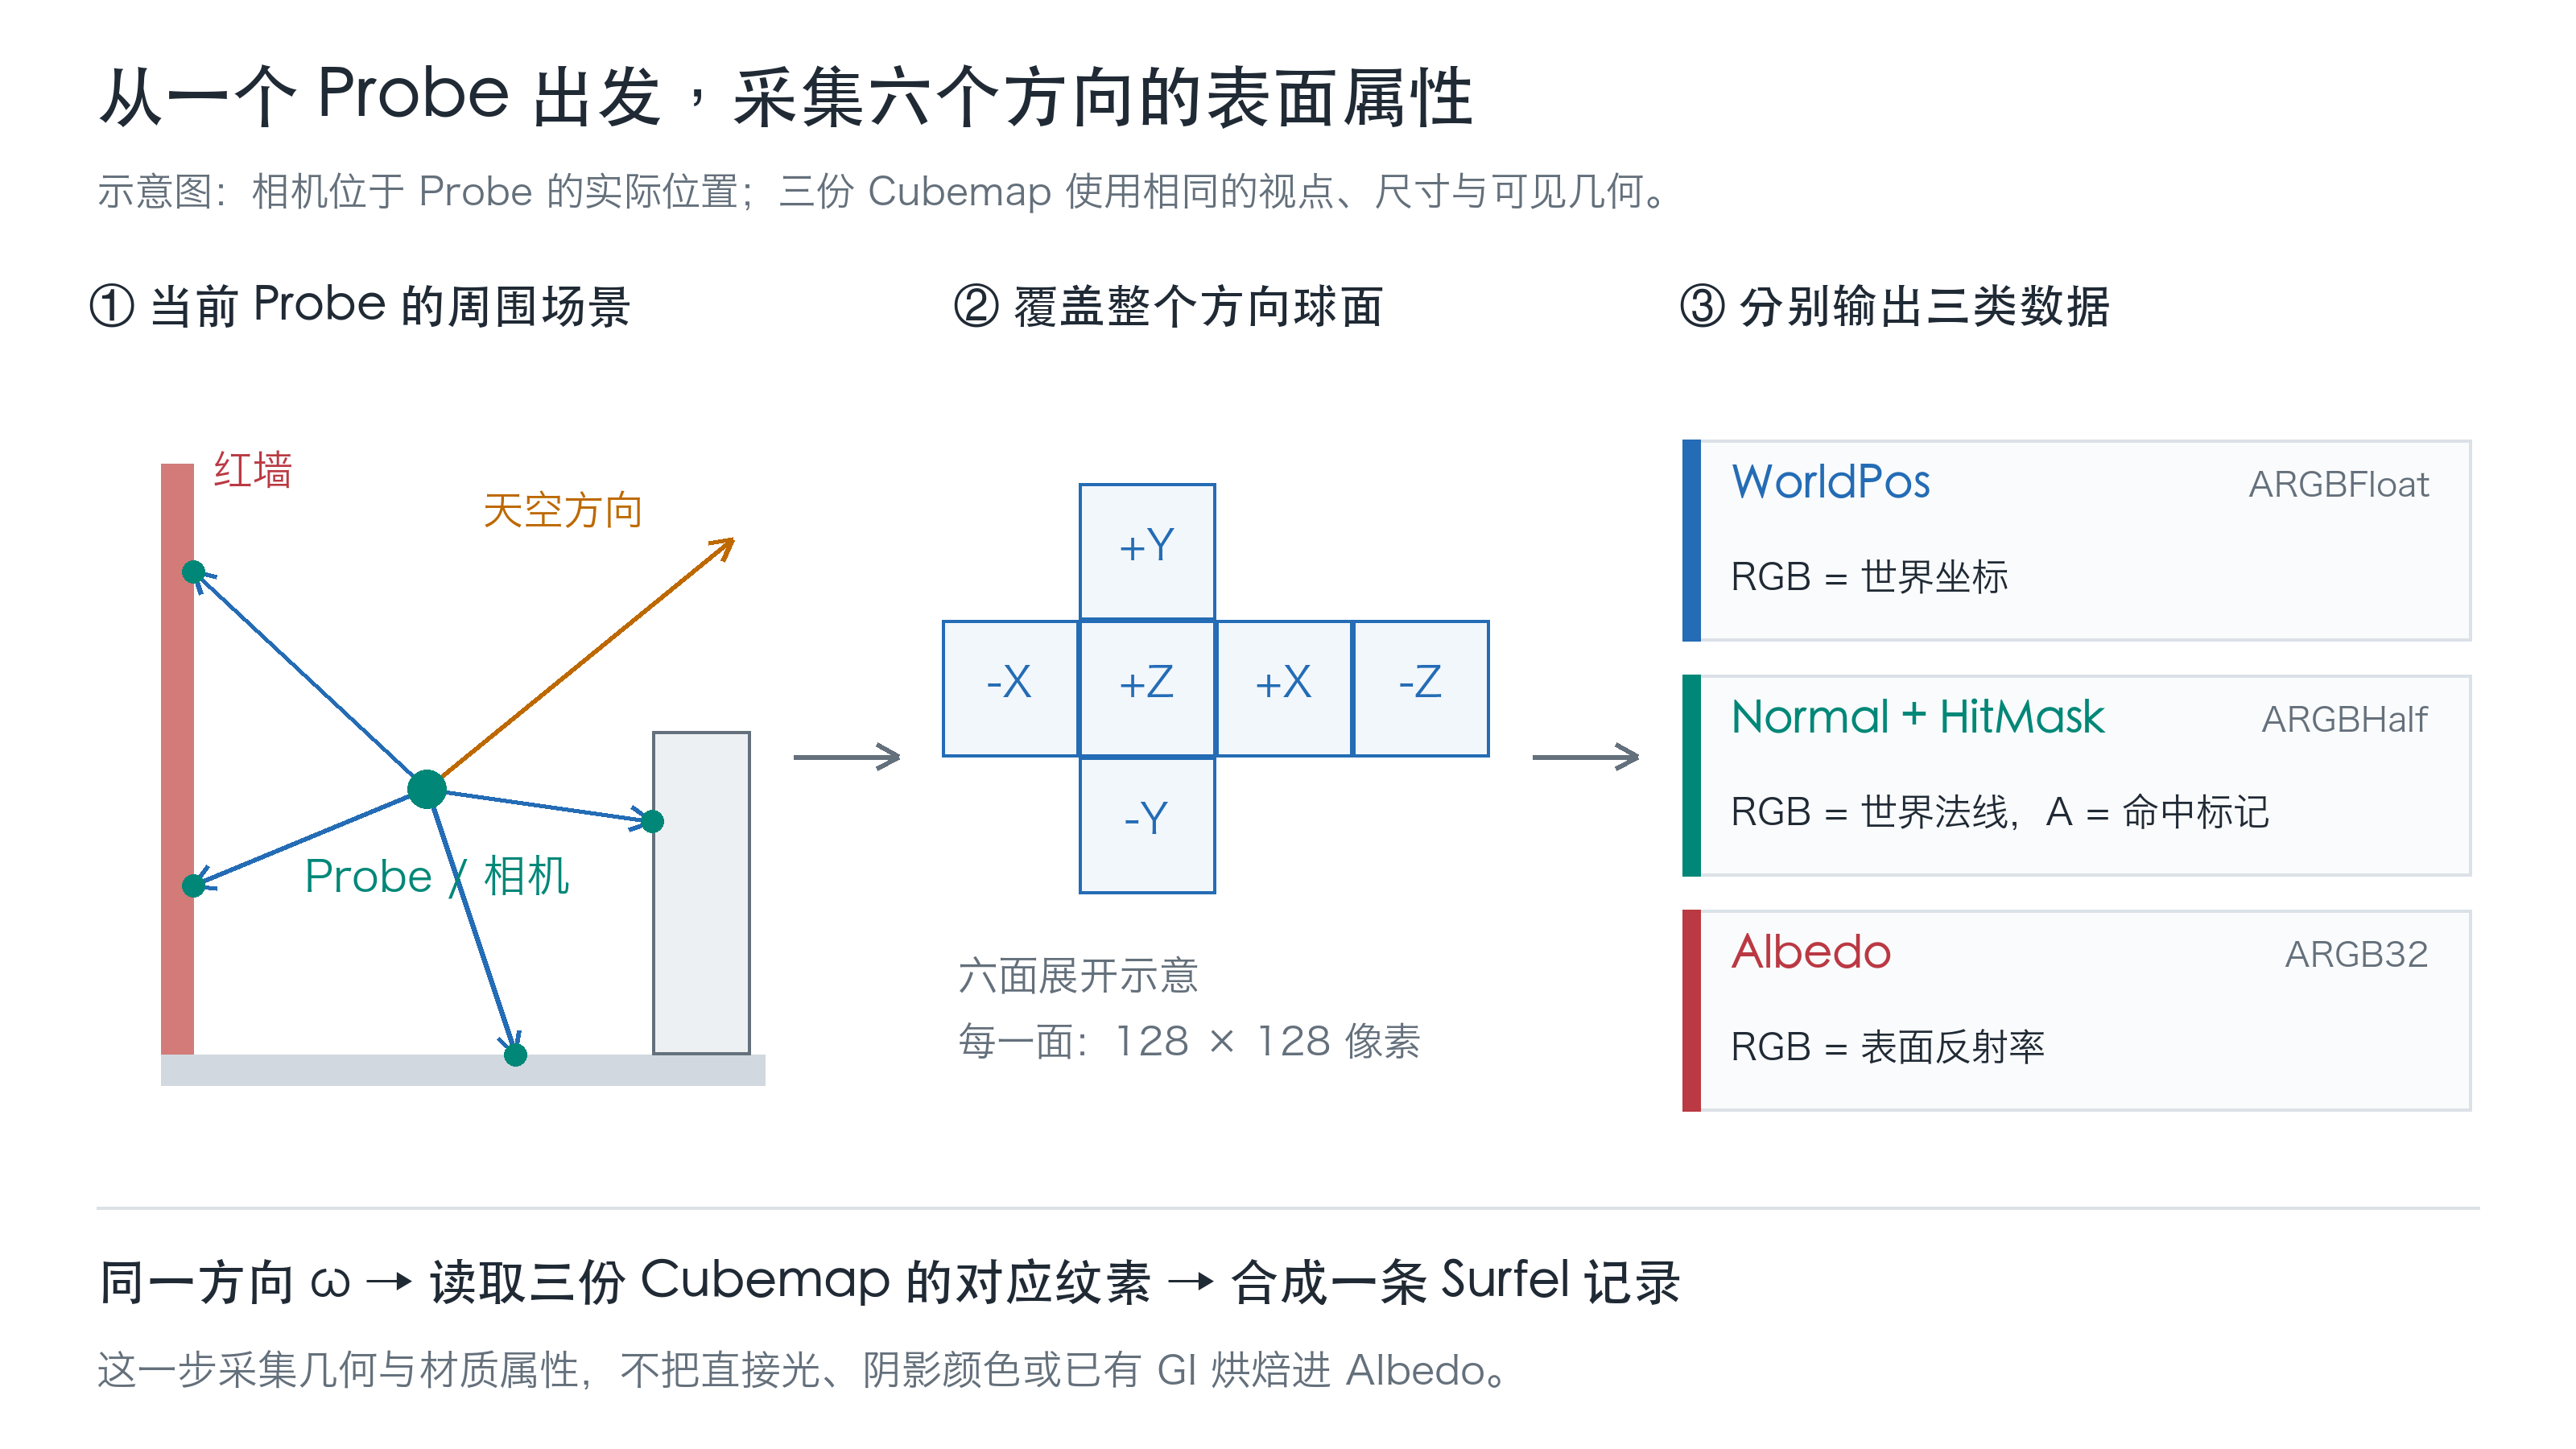
图:三份Cubemap共享同一套观察方向,用同一个方向读取它们,才能组合成同一个可见表面的记录。
当前每个面的分辨率为128\times128。代码会依次调用三次 RenderToCubemap,分别采集位置、法线和Albedo,相当于完成三类属性、各六个面视角的输出。
每份Cubemap都配有24位深度缓冲。深度测试负责保留对应纹素中最近的可见表面,被前方物体遮挡的表面不会覆盖它。这样,在Surfel提取阶段就可以通过查图近似获得方向可见性,而不必为每条采样方向重新遍历场景三角形求交。
这里仍然存在光栅化分辨率、背面剔除和相机裁剪范围带来的限制,它并不等同于无限精度的射线求交。临时相机的近裁剪面设为 0.01,远裁剪范围也应覆盖需要采集的场景;超出裁剪范围而未被渲染的物体,会使相应方向被误当成天空。
三个属性Shader的输出也各有要求:位置必须保留浮点数值和负坐标;法线需要变换到世界空间,并在片元阶段重新归一化;Albedo只记录反射率,不能混入已经计算过的光照。当前法线采集使用网格法线及其插值,并没有额外应用材质的法线贴图。
3. 从球面方向提取Surfel
Cubemap建立后,并不需要把六个面的所有纹素都保存为Surfel。我们只选取 SurfelSampleCount个球面方向,再用这些方向查询三份Cubemap。
这里需要注意:均匀挑选Cubemap纹素,并不等于按球面面积均匀采样,因为不同位置的纹素对应的立体角不同。本实现先在球面上生成方向,再查Cubemap,从而把方向分布与Cubemap的展开方式分开。
Hammersley二维采样与球面映射
SurfelSampleCS.compute使用Hammersley低差异序列生成二维点(u,v)\in[0,1)^2。其中一个维度由样本索引和总数构成,另一个维度使用位反转得到的序列,并加入种子扰动。这种分布有助于减少少量纯随机点容易出现的聚簇和空洞。
得到二维点后,不能直接把两个数分别当作均匀分布的方位角和极角。若令极角\theta=\pi v,球面两极附近会聚集过多样本。当前代码改为令\cos\theta均匀分布:
这里以Z轴作为球坐标的极轴,得到单位方向\boldsymbol{\omega},满足\lVert\boldsymbol{\omega}\rVert_2=1。换用其他极轴不会改变均匀球面采样的性质。Probe采样覆盖的是整个球面,而不是围绕某个表面法线的半球。
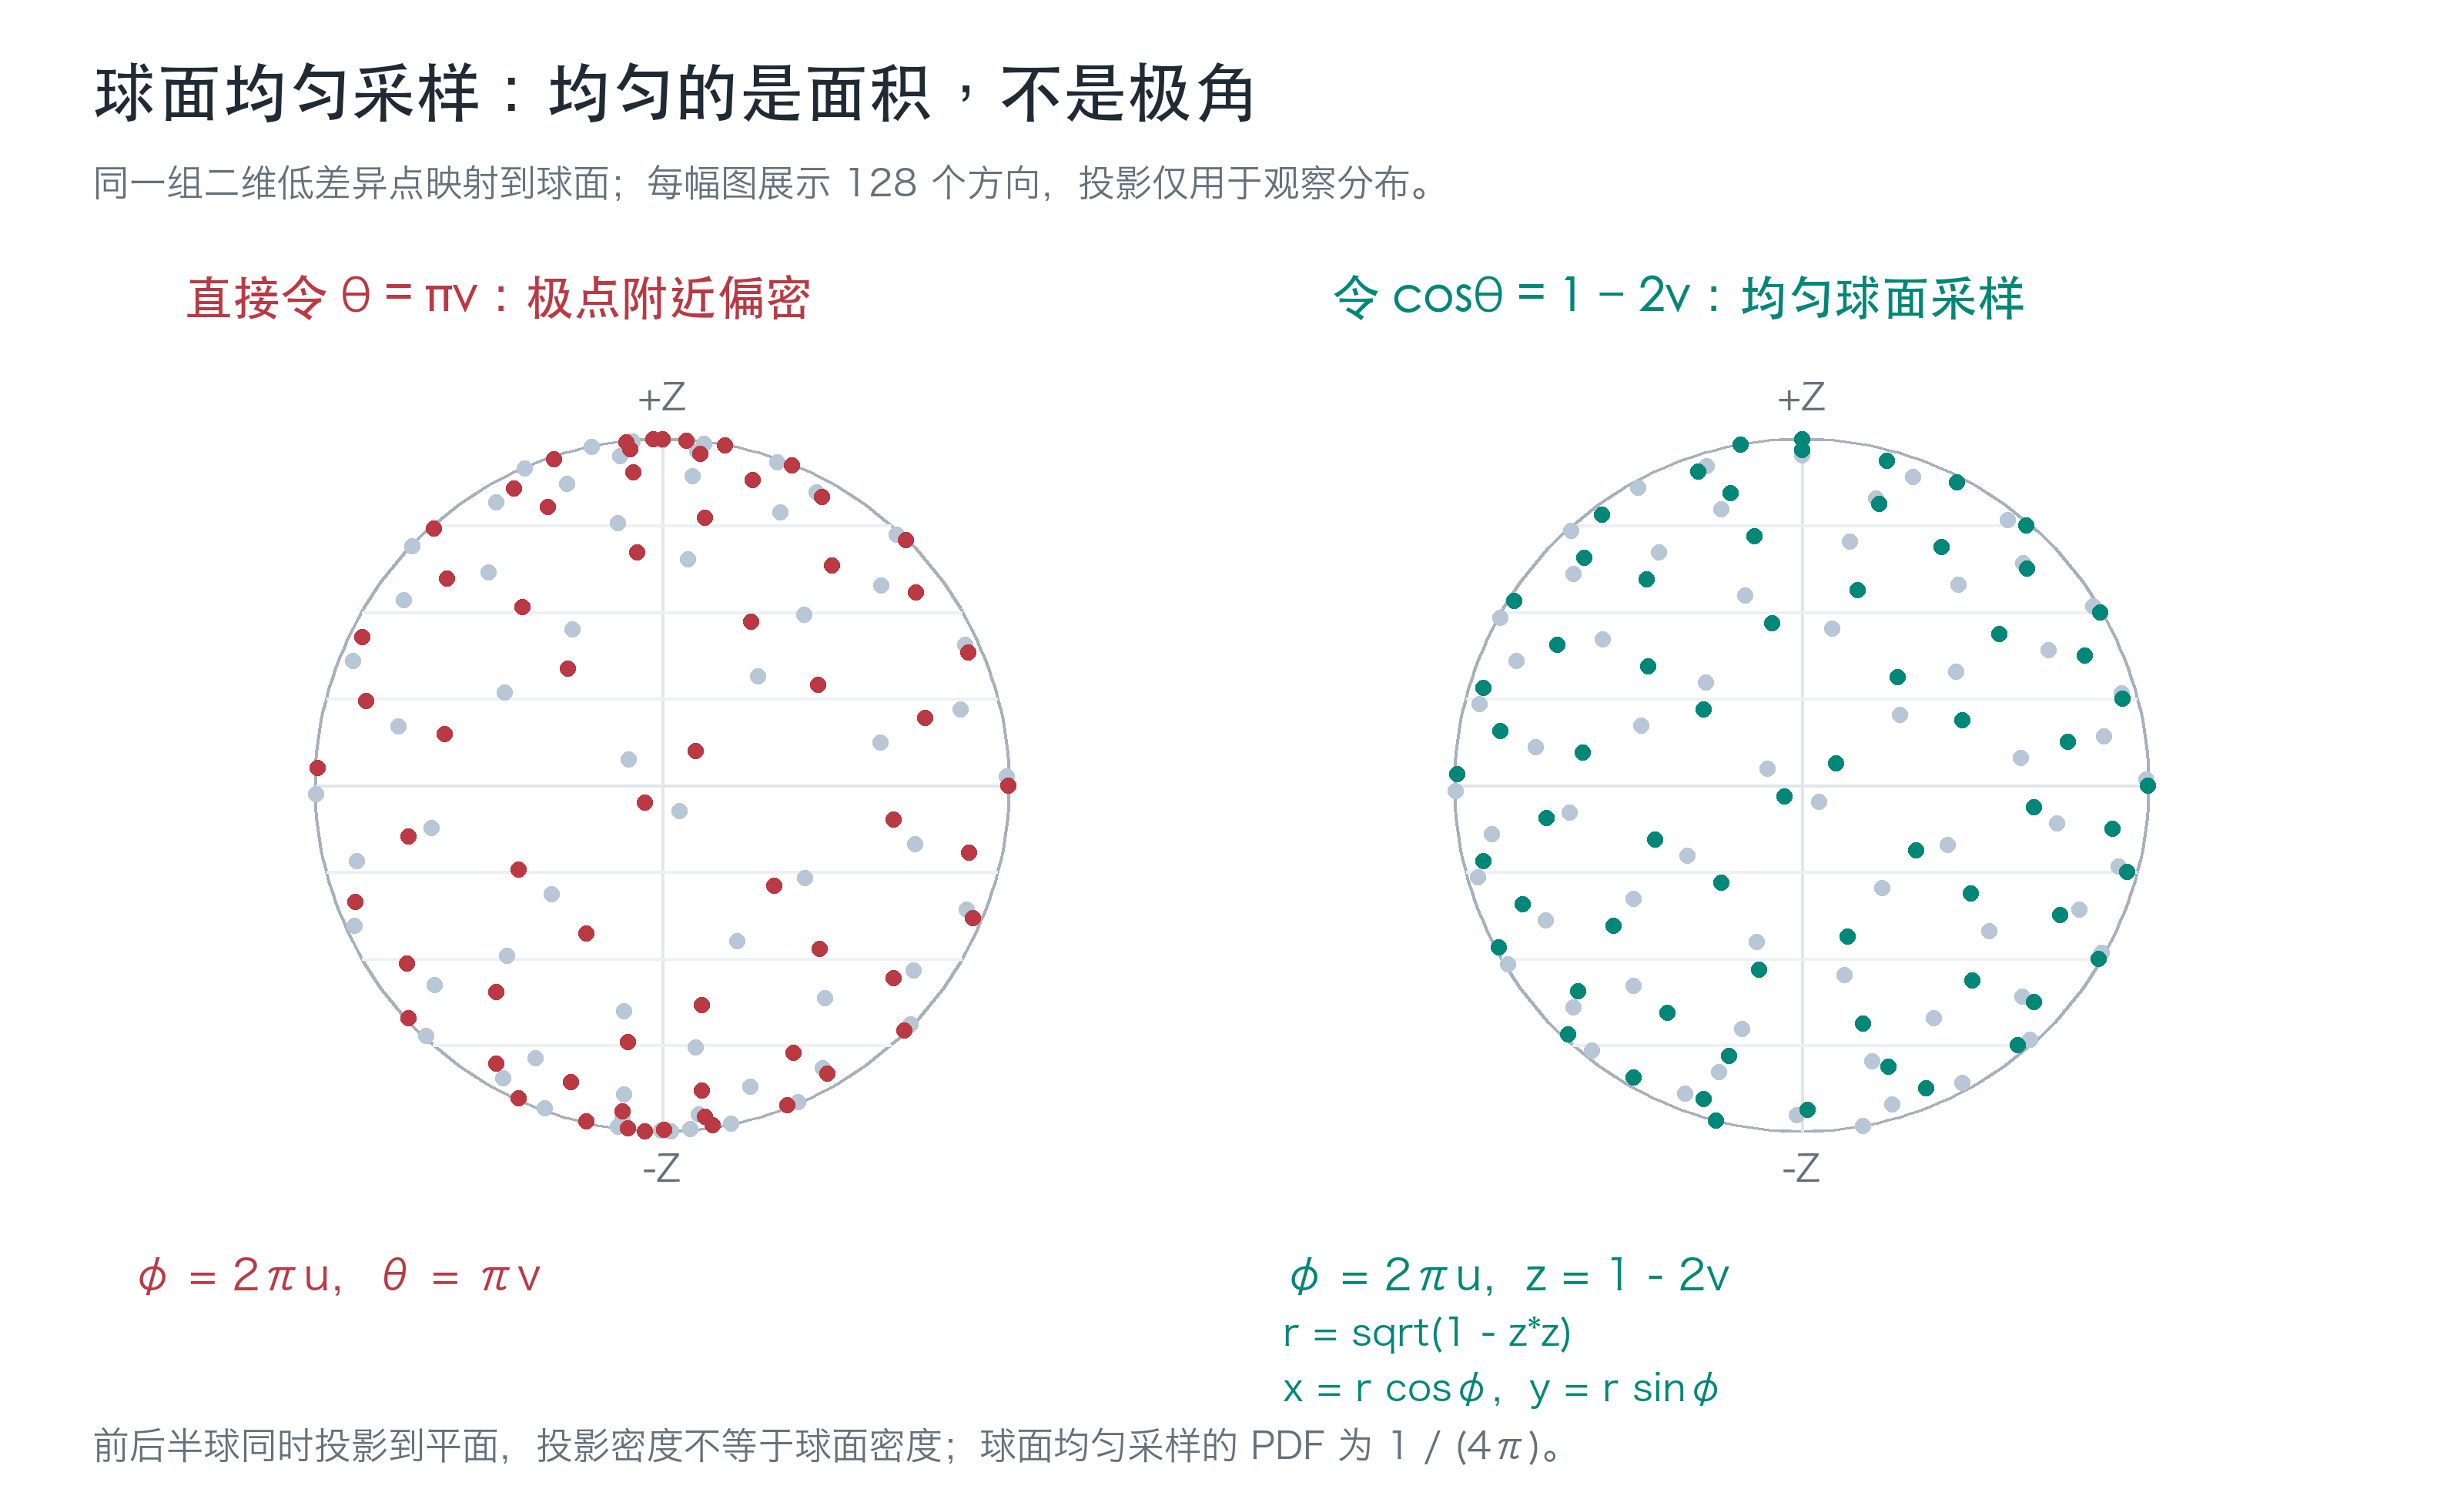
图:左侧在两极附近明显聚集;右侧通过对\cos\theta均匀采样改善球面覆盖。图中为球面点的平面投影,不能直接把投影后的密度当作球面面积密度。
均匀球面分布对应的概率密度,以及N个样本中每个样本的理论积分权重为:
这个权重将用于后续球谐投影,具体计算留到Relight章节介绍。
当前随机种子是在采集每个Probe时设置的。烘焙完成后,Surfel数组就固定下来,运行时不会每帧重新抖动这些采样方向。代码中的种子扰动应理解为采集阶段的采样变化,而不是运行时的时域采样。
同一个方向读取三份属性
对每个方向 dir,Compute Shader读取对应的位置、法线和Albedo:
result.position = _worldPosCubemap.SampleLevel(sampler_point_clamp, dir, 0).rgb;
result.albedo = _albedoCubemap.SampleLevel(sampler_point_clamp, dir, 0).rgb;

float4 normalAndMask = _normalCubemap.SampleLevel(sampler_point_clamp, dir, 0);
result.normal = normalAndMask.xyz;
result.skyMask = saturate(1.0 - normalAndMask.w);
这里使用Point采样和第0级Mip,并关闭Cubemap的MipMap生成。原因是这些纹理记录的是属性数据:如果在两个不同物体之间做线性插值,可能得到一个根本不存在的世界位置,或者混合了两个表面的法线和颜色。
不过,Point采样也意味着方向会落到有限分辨率的纹素上。多个方向可能读取同一个纹素,较小的几何细节也可能在渲染Cubemap时就已经丢失。因此,Cubemap分辨率决定可见性与属性的角分辨率,Surfel数量决定从中抽取多少方向样本。单纯增加Surfel数量,不能恢复Cubemap中没有记录下来的细节。
4. 如何区分命中表面与天空
Normal Cubemap在渲染前清为(0,0,0,0)。当几何通过深度测试时,Shader输出 float4(normalWS, 1),因此Alpha可以充当命中标记。令h表示Normal图的Alpha值,s表示 skyMask,则:
这个标记不能用“Albedo是否为黑色”代替,因为黑色材质仍然是真实表面;也不能只看世界坐标是否为零,因为原点同样可能存在几何。
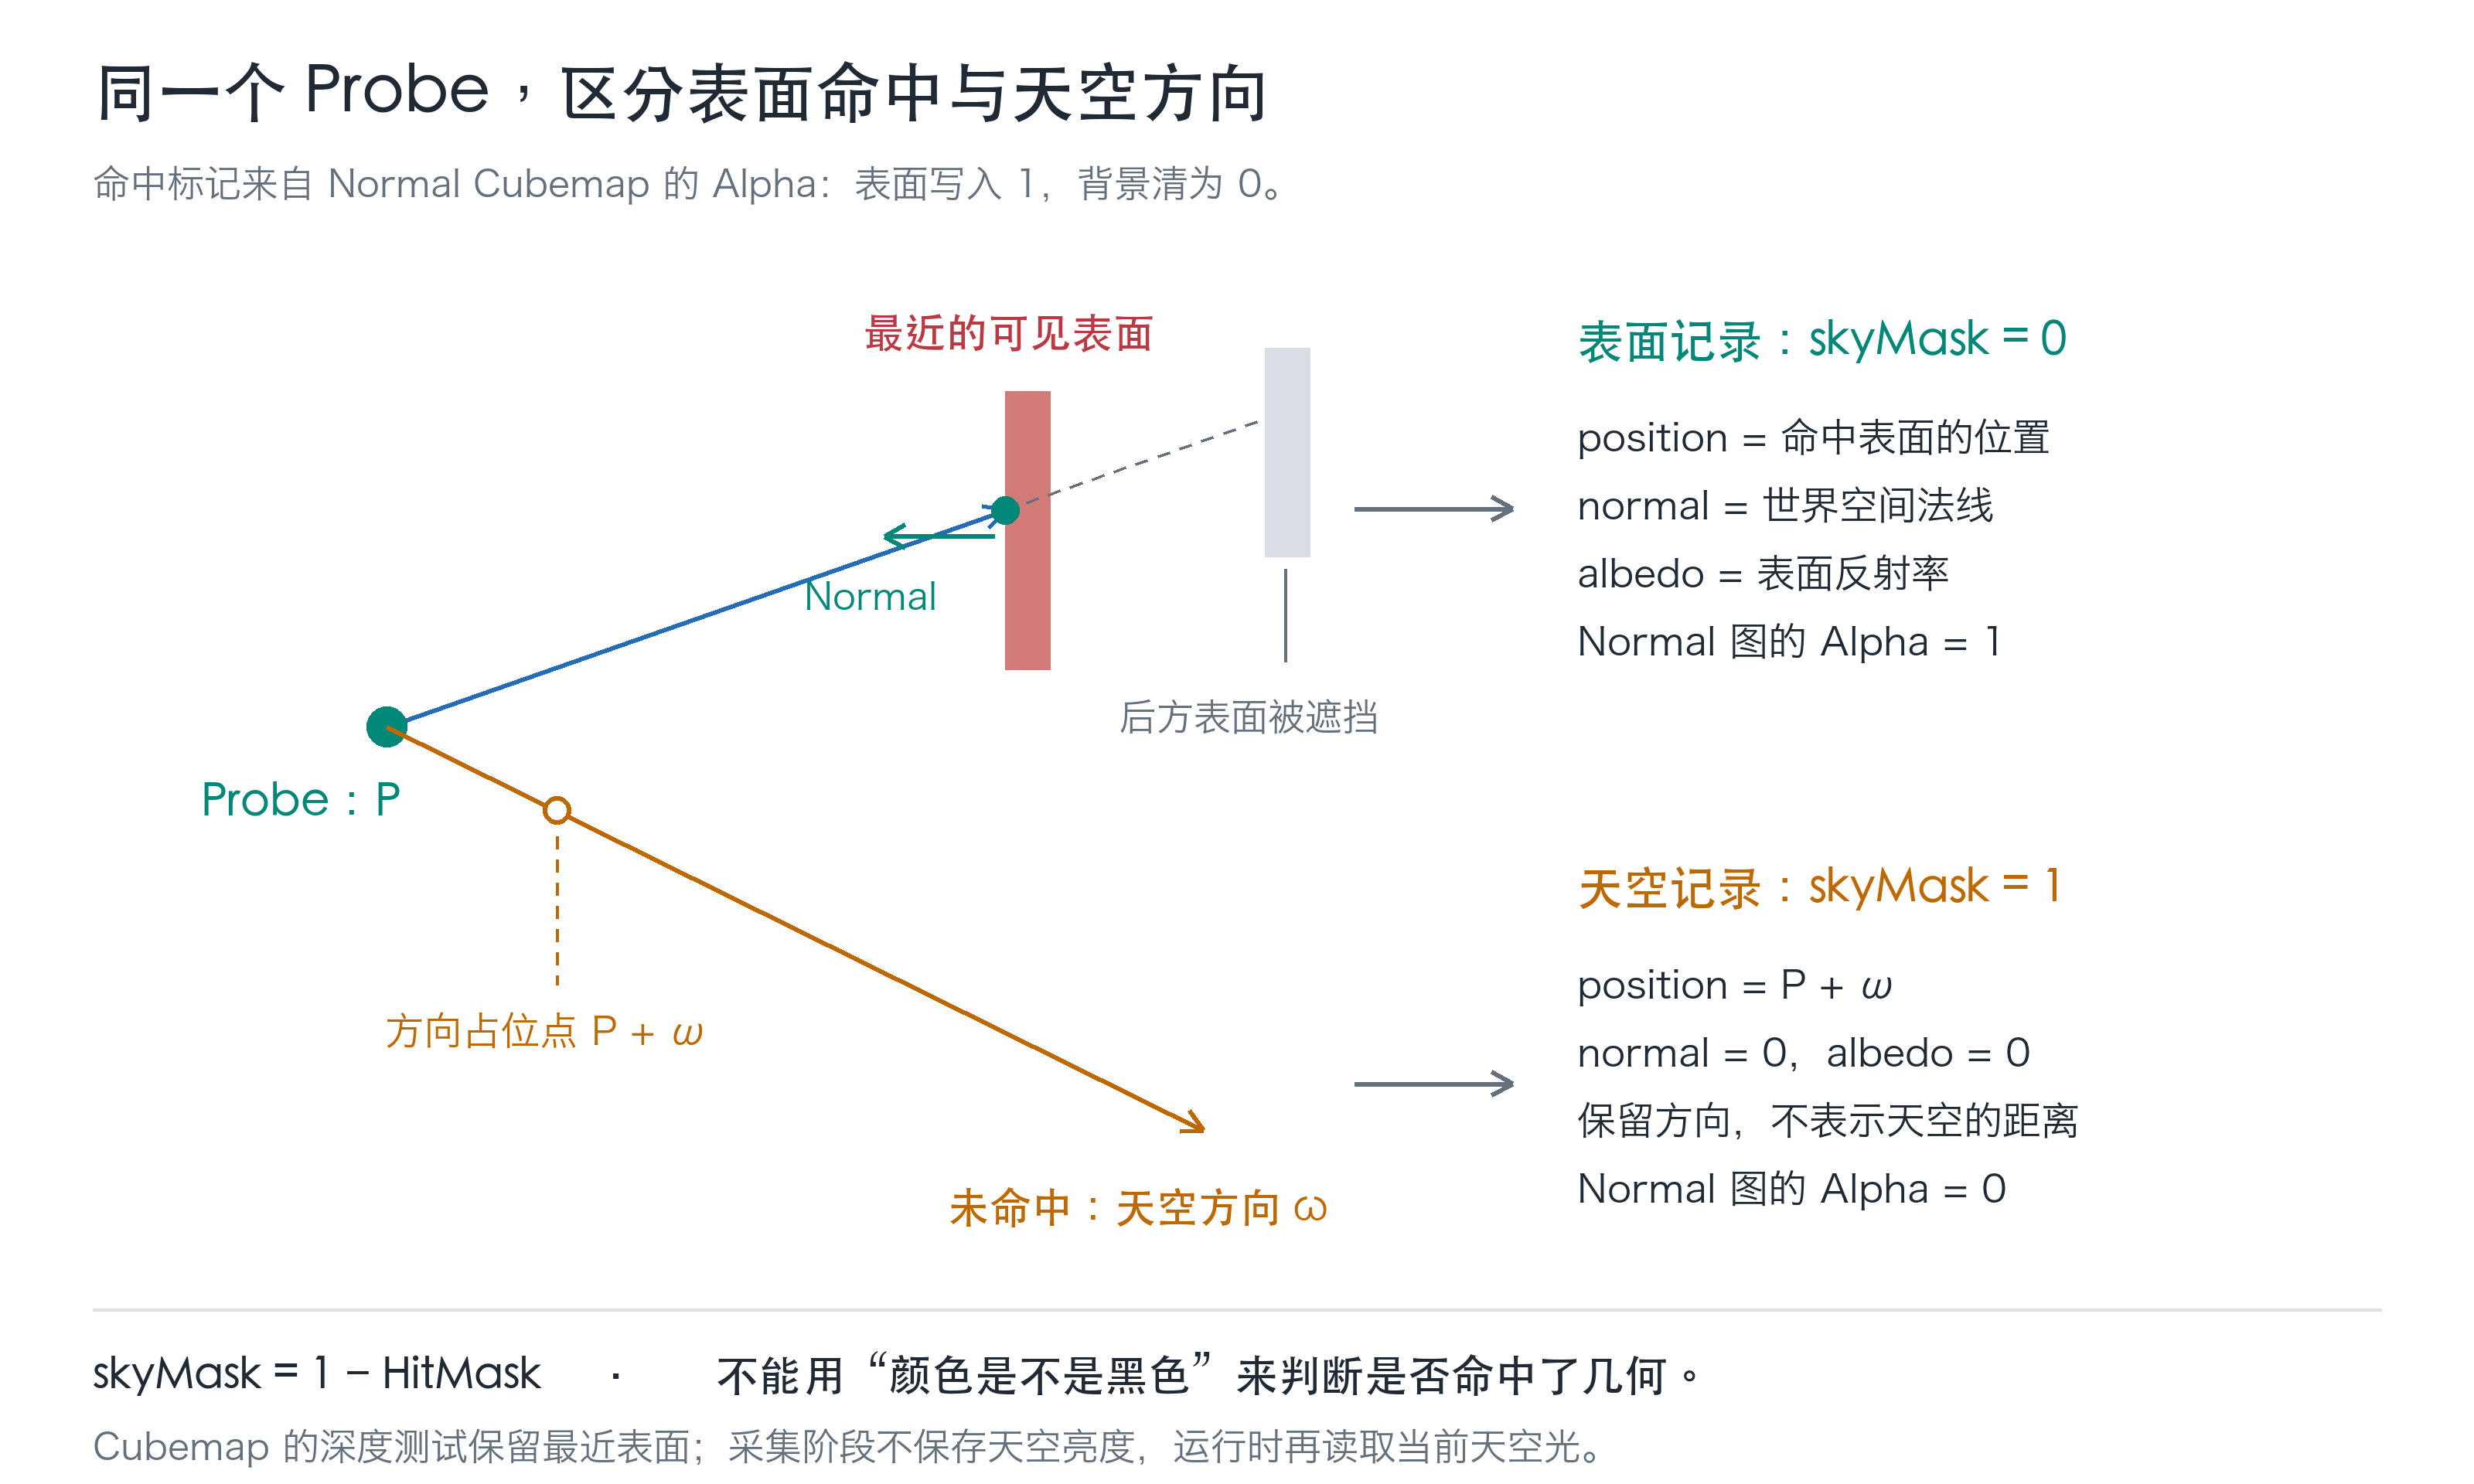
图:表面方向保存最近命中的几何属性;天空方向没有真实命中位置,需要用单独的标记与方向表示。
对于天空方向,三份Cubemap的背景数值都为零。令\mathbf{p}为Probe位置,\mathbf{x}为记录的位置,后续可以通过以下公式恢复方向:
因此,采样Shader会给天空记录构造一个占位位置:
result.position += (_probePos.xyz + dir) * result.skyMask;
令\mathbf{x}_{\mathrm{hit}}为命中表面的位置,这段代码对应:
当\mathrm{skyMask}=0时,真实表面位置保持不变;当\mathrm{skyMask}=1时,背景位置原本为零,最终得到\mathbf{p}+\boldsymbol{\omega}。这个点只是方向的编码方式,不表示天空真的位于距离Probe一个单位的位置,也不能把它当作表面距离参与衰减计算。
天空记录的 normal和 albedo保持为零。此时只保存“这个方向没有命中采集范围内的几何”,不保存天空亮度;运行时再根据方向读取当前天空光,所以天空强度仍然可以动态变化。
5. GPU采样、回读与数据保存
当前采样Kernel使用 [numthreads(32,16,1)],每个线程组包含32\times16\times1=512个线程,一条有效线程负责生成一条记录。设实际样本数为N=\mathrm{SurfelSampleCount},线程组数量为G,则:
其中g对应 groupID.x,\ell\in\{0,1,\ldots,511\}对应组内线程索引,i为最终的 surfelIndex。只有i<N的线程参与有效采样。
超出 SurfelSampleCount的线程直接返回。例如,采集1000个样本时需要两个线程组,共1024个线程,最后24个不写入有效结果。Hammersley序列使用的总数仍然是1000,而不是补齐后的1024,避免改变采样分布。
Compute Shader完成后,通过 ComputeBuffer.GetData回读结果,只取前N条有效记录,转换为CPU侧的Surfel数组,存入当前Probe的 surfels字段,最后随分块写入 .probe文件。
这里必须保持GPU字段布局一致。本实现的GPU记录为:
| 字段 | GPU类型 | 大小 |
|---|---|---|
position |
float3 |
12字节 |
normal |
float3 |
12字节 |
albedo |
float3 |
12字节 |
skyMask |
float |
4字节 |
每条GPU记录的总大小为:
CPU侧的 Surfel使用了带Alpha的 Color,字段顺序也与GPU记录不同,因此通过专用的 GpuSurfel结构逐字段转换,不能把CPU结构直接当作同一布局上传。若把 skyMask与Albedo通道错位,可能出现反射光颜色错误,甚至把表面反射率误读成天空可见度。
三份Cubemap和采样缓冲在采集过程中重复使用,并不是为每个Probe长期保留三份Cubemap。最终保存的是方向样本记录。若共有P个Probe,每个Probe保存N条记录,则记录总数为PN,对应GPU Surfel数据的大小约为:
这个估算不包含其他GPU缓冲,也不代表CPU结构或序列化文件的实际大小。
6. 采集过程中的几个关键约束
在这一阶段,数据的正确性比画面是否“好看”更重要。采集相机输出的是几何属性,因此需要把普通渲染中的一些行为隔离出去:
- 隐藏探针可视化球。 否则它们也会被相机看到,成为错误的可见表面。
- 关闭Relight、Composite和后处理对采集的影响。 当前通过采集状态标记跳过PRT渲染Feature,同时关闭相机后处理,防止GI或颜色处理污染GBuffer。
- 使用线性数据纹理。 世界坐标和法线不能进行颜色编码或色调映射,Albedo也应作为后续光照计算使用的反射率保存。
- 保留深度缓冲,关闭MSAA。 深度缓冲保证最近表面的选择;关闭MSAA可避免边缘混合把命中标记变成部分覆盖值。
- 使用临时材质副本并恢复原材质。 切换属性Shader时保留原有的纹理与颜色参数,采集结束后恢复Renderer的材质引用。
当前属性Shader主要对应本工程的不透明网格及 _BaseMap、_BaseColor材质约定。透明、Alpha Clip、法线贴图等行为若要参与采集,需要补充相应的Shader逻辑,不能假定替换Shader后会自动保留原材质的全部渲染行为。
至此,每个Probe都拥有了一组描述周围可见表面和天空方向的数据。接下来进入Relight:保留这些离线几何记录,根据当前光源重新计算光照。
运行时Relight
Relight的任务是:读取已经烘焙的Surfel,计算各方向的Radiance,再更新Probe的球谐系数。 本节采用漫反射模型;历史间接光只作为一个输入项,多次反弹的传播过程留到下一章。
1. 准备本帧更新的数据
RelightRenderFeature在URP的 AfterRenderingOpaques阶段执行,此时可以使用当前帧的主光信息和阴影贴图。它绑定Surfel数组、Probe位置、实际样本数、天空Cubemap和SH缓冲,并为本帧选中的Probe提交Compute任务。
当前通过相机距离和每帧预算筛选Probe,再用 _relightProbeIndices把线程组映射到实际探针下标。开始更新时,先把历史SH复制到输出缓冲,再覆写选中的探针,保证未更新的Probe仍保留原有光照。同一帧不会因多相机重复渲染而多次推进Relight。
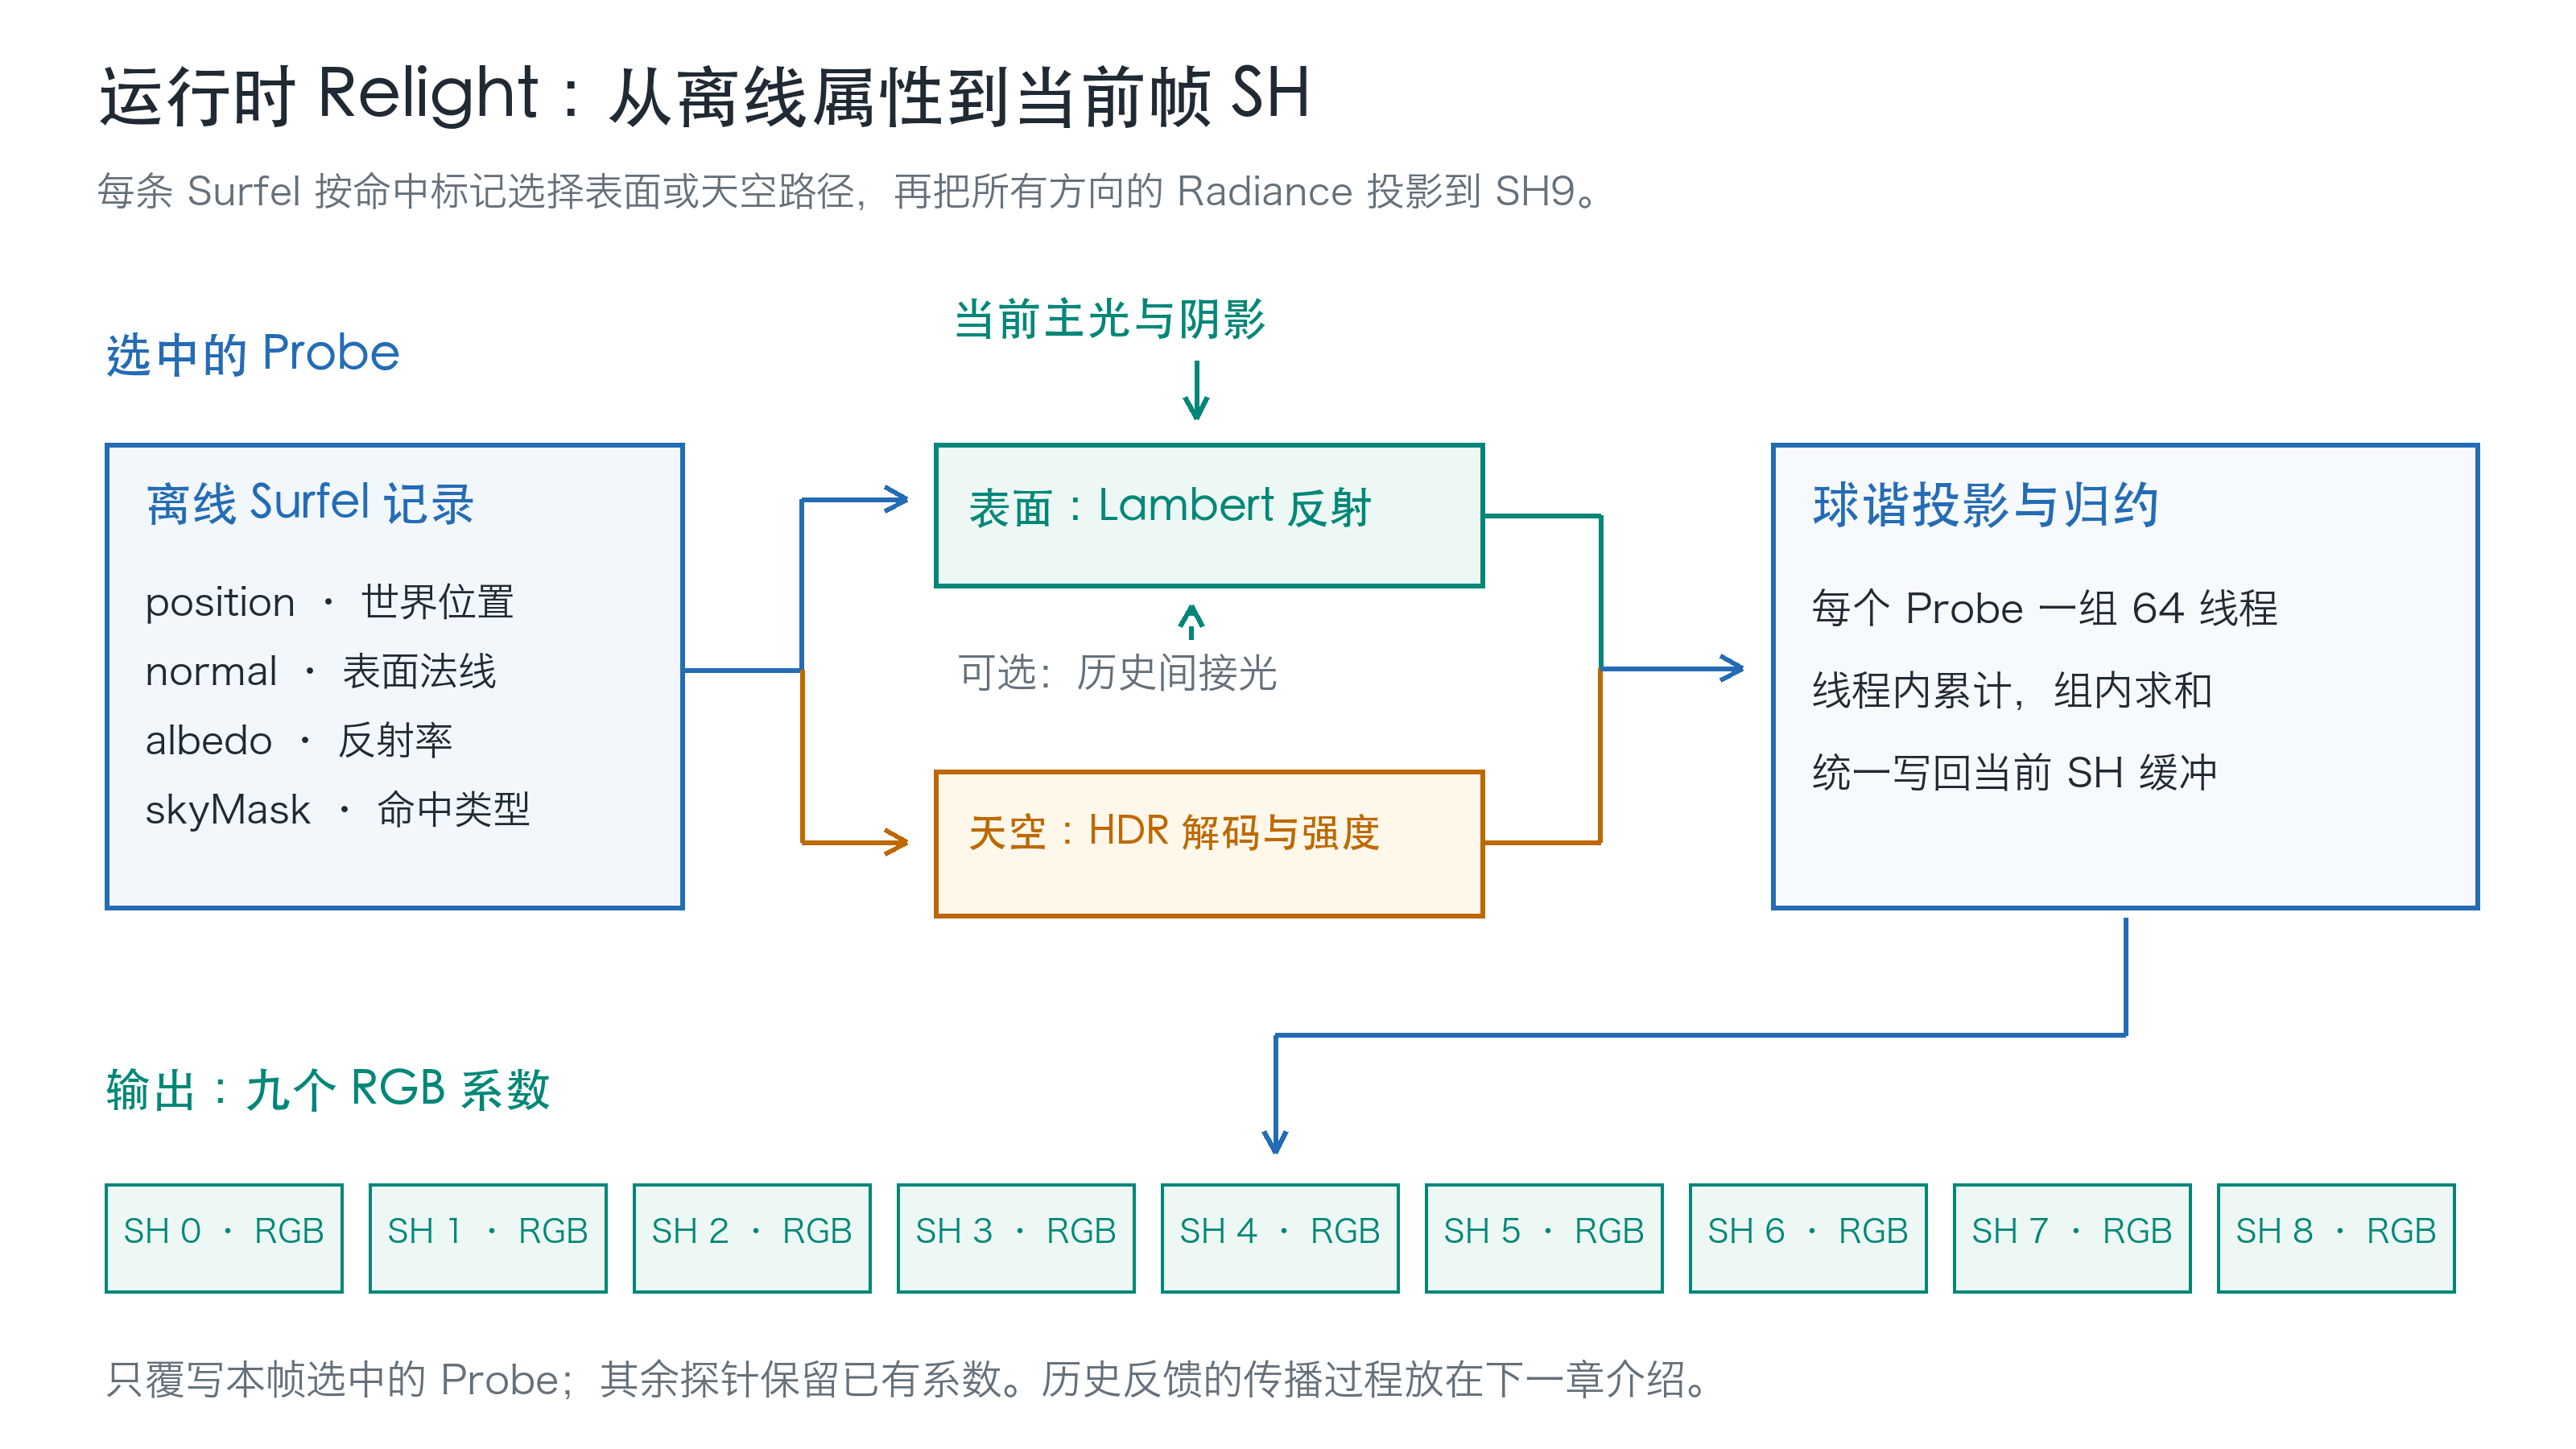
2. 计算每条Surfel的Radiance
设Probe位置为\mathbf{p},第i条记录的位置为\mathbf{x}_i,其入射方向为:
对命中表面的样本,设\hat{\mathbf{n}}_i为单位法线,\hat{\mathbf{l}}为指向主光的方向,\mathbf{C}_{\mathrm{light}}为主光的线性RGB强度,V_i为阴影衰减,则直接光辐照度为:
当前直接光项只接入URP主光,附加灯光尚未参与这一步。结合表面反射率\boldsymbol{\rho}_i、历史间接辐照度\mathbf{E}_{\mathrm{history},i}和天空标记s_i,得到:
其中\odot表示RGB逐分量相乘,\boldsymbol{\rho}_i限制在[0,1],\beta对应 BounceIntensity,I_{\mathrm{sky}}对应 SkyLightIntensity。关闭历史反馈时令\beta=0
表面分支使用Lambert反射,因此需要乘\boldsymbol{\rho}_i/\pi;天空分支先解码HDR环境贴图,再乘天空强度,不乘表面Albedo,也不参与表面历史反射。这里传递的是Radiance,不额外按Probe到Surfel的距离平方衰减;几何在方向采样中所占的范围已经影响其贡献。
3. 将Radiance投影到SH9
Probe需要保存的是入射Radiance的方向分布,而不只是一个平均颜色。保留球谐的l=0,1,2频带,共得到九个RGB系数:
这里的N是当前Probe的实际样本数,权重4\pi/N来自前面的均匀球面采样。SH基函数可能为负,因此系数也可能为负,不能把它们当作颜色直接截断到非负范围。
实现中,每个Probe对应一个64线程的线程组。组内线程按步长64分担样本,各自累计九项 float3,再通过共享内存归约求和,最后由一个线程覆写该Probe的九个系数。默认512个样本时,每个线程处理8条记录。浮点归约也避免了逐样本转为定点整数再累加造成的精度损失。
此时保存的仍是Radiance的SH系数,还没有完成针对某个接收表面的余弦卷积。 后续根据接收表面的法线求出Irradiance,再乘该表面的Albedo与Lambert系数,才得到最终的间接出射光。下一章先介绍如何把上一帧的光照反馈到Surfel,逐步模拟更多次反弹。
N-Bounce模拟
关闭历史反馈时,Relight得到的是当前主光的表面反射与可见天空光。若再把上一帧的Probe光照作为Surfel接收的间接光,就能让光沿“红墙→白色方块→其他表面”等路径继续传播。这里的N-Bounce是通过历史反馈逐步引入更高阶反射,不是在一帧内重新追踪N段光线。
1. 历史光照如何成为下一次反弹
对每个表面Surfel,先在其位置和法线方向采样历史SH,得到间接辐照度,再乘该Surfel的反射率与Lambert系数。得到的Radiance与当前直接光贡献一起,重新投影到Probe的SH中。天空样本只提供天空入射光,不参与表面反馈。
设\mathbf{H}_n为第n轮的整组Probe系数,\mathbf{D}为无历史反馈时的基础结果,\mathcal{T}表示历史采样、表面反射和重新投影组成的传播过程,则:
其中\mathbf{D}同时包含直接光照亮表面的贡献和可见天空的贡献。若光源固定、每轮更新全部Probe,并把传播近似为线性算子,则:
后续轮次逐渐加入更长的反射路径。实际实现包含SH重建后的非负截断,因此上式的线性展开用于解释传播过程,并不是精确的路径追踪结果。
2. 用双缓冲隔离历史与当前结果
同一次Dispatch不能一边修改SH,一边把这份正在变化的数据当作历史读取,否则不同线程可能读到不同版本。当前使用两份缓冲:
_historyShCoefficients:保存上一帧结果,本帧只读。_shCoefficients:接收本帧输出,供后续着色使用。
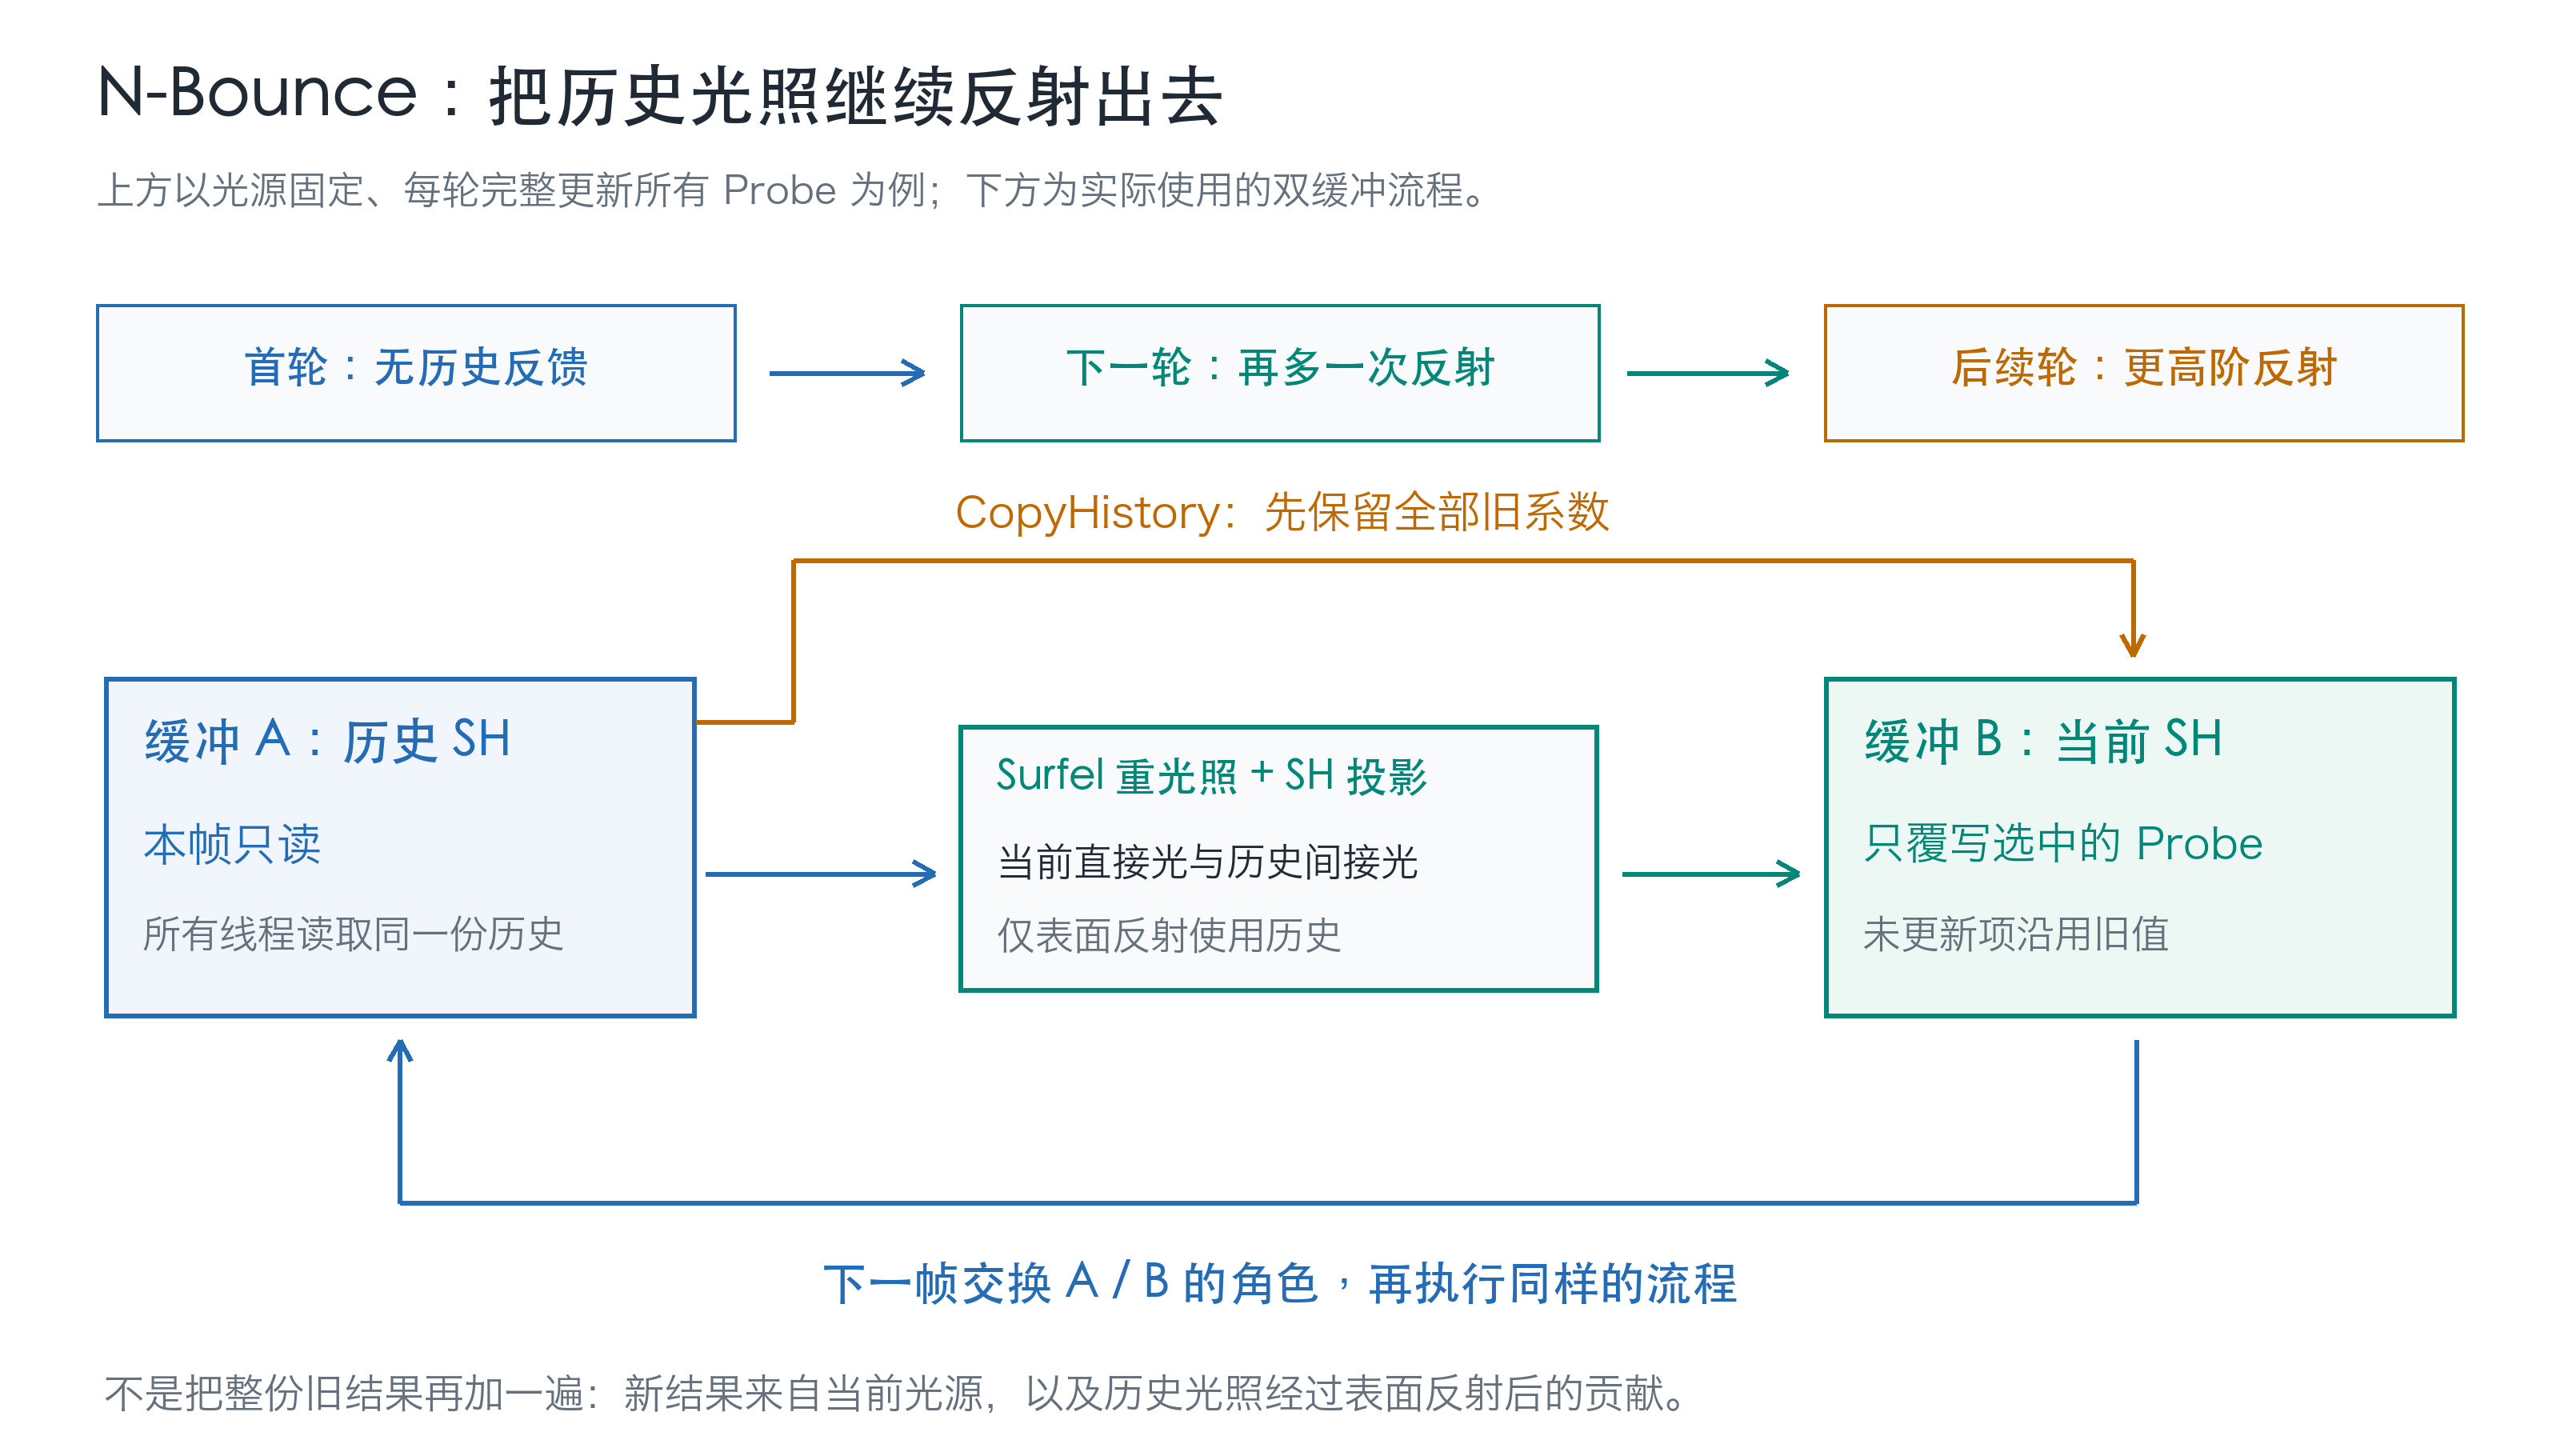
每帧先交换两份缓冲的角色,再由 CopyHistory复制全部旧系数,最后由Relight覆写选中的Probe。复制的目的是保留本帧未更新的探针,不是把旧SH直接累加到新结果上;历史能量必须经过Surfel的反射计算,才能进入新的输出。
3. 收敛速度与分批更新
MultiBounce控制是否启用反馈,BounceIntensity对应\beta\in[0,1]。减小\beta会削弱高阶反射,设为0则恢复无历史反馈的结果。GIIntensity只调整最终显示亮度,不参与这个反馈环。
当前每帧只更新相机范围内的一部分Probe。若候选集合固定,包含K个探针,每帧预算为M>0,完成一次轮询大约需要:
它只表示刷新周期,不是严格的反弹次数换算:不同批次读取的历史可能包含不同深度的传播结果。预算越小,光源变化后的响应和收敛通常越慢;范围外的探针则保留旧光照,直到重新进入更新范围。
新建缓冲、切换分块或改变有效反馈强度时会清空历史,也可以通过 Reset GI History手动重置。普通光源变化不会立即抹掉旧结果,而是随更新逐渐替换;关灯后,历史光照也需要若干轮才能衰减。
稳定性仍取决于反射率、采样与可见性近似,不能仅凭\beta\le1保证任意场景都收敛。多次反弹不会修正错误的遮挡,反而可能放大漏光;几何发生变化时,仍需重新烘焙对应数据。
GPU八叉树结构与遍历
GPU八叉树负责一个查询:给定世界空间位置,找到所属叶子及其八个角点Probe。 它以连续节点数组上传到GPU,Shader通过整数下标访问,不需要CPU字典或对象引用。
1. 节点布局与连续子节点
每个 GpuOctreeNode包含十个32位无符号整数,C#与HLSL的字段顺序一致,步长为10\times4=40\ \text{bytes}:
| 字段 | 作用 |
|---|---|
hashCode |
VTCode,用于恢复节点层级与空间范围 |
childBase |
八个直接子节点在数组中的起始下标 |
probeIndex0~probeIndex7 |
叶子八个角点对应的Probe下标 |
节点数组下标、VTCode、Probe下标是三种不同的编号。 根节点位于数组下标0;childBase=0xFFFFFFFFu表示叶子,而角点索引为该值时表示没有有效Probe。下标0本身是合法值。
生成器在展开一个节点时,先在数组尾部预留八个槽位,再递归填写子节点。这样,八个直接子节点始终连续,不会被某个孩子的后代插开。稀疏性来自较早终止细分,而不是省略已展开节点的部分孩子槽位。
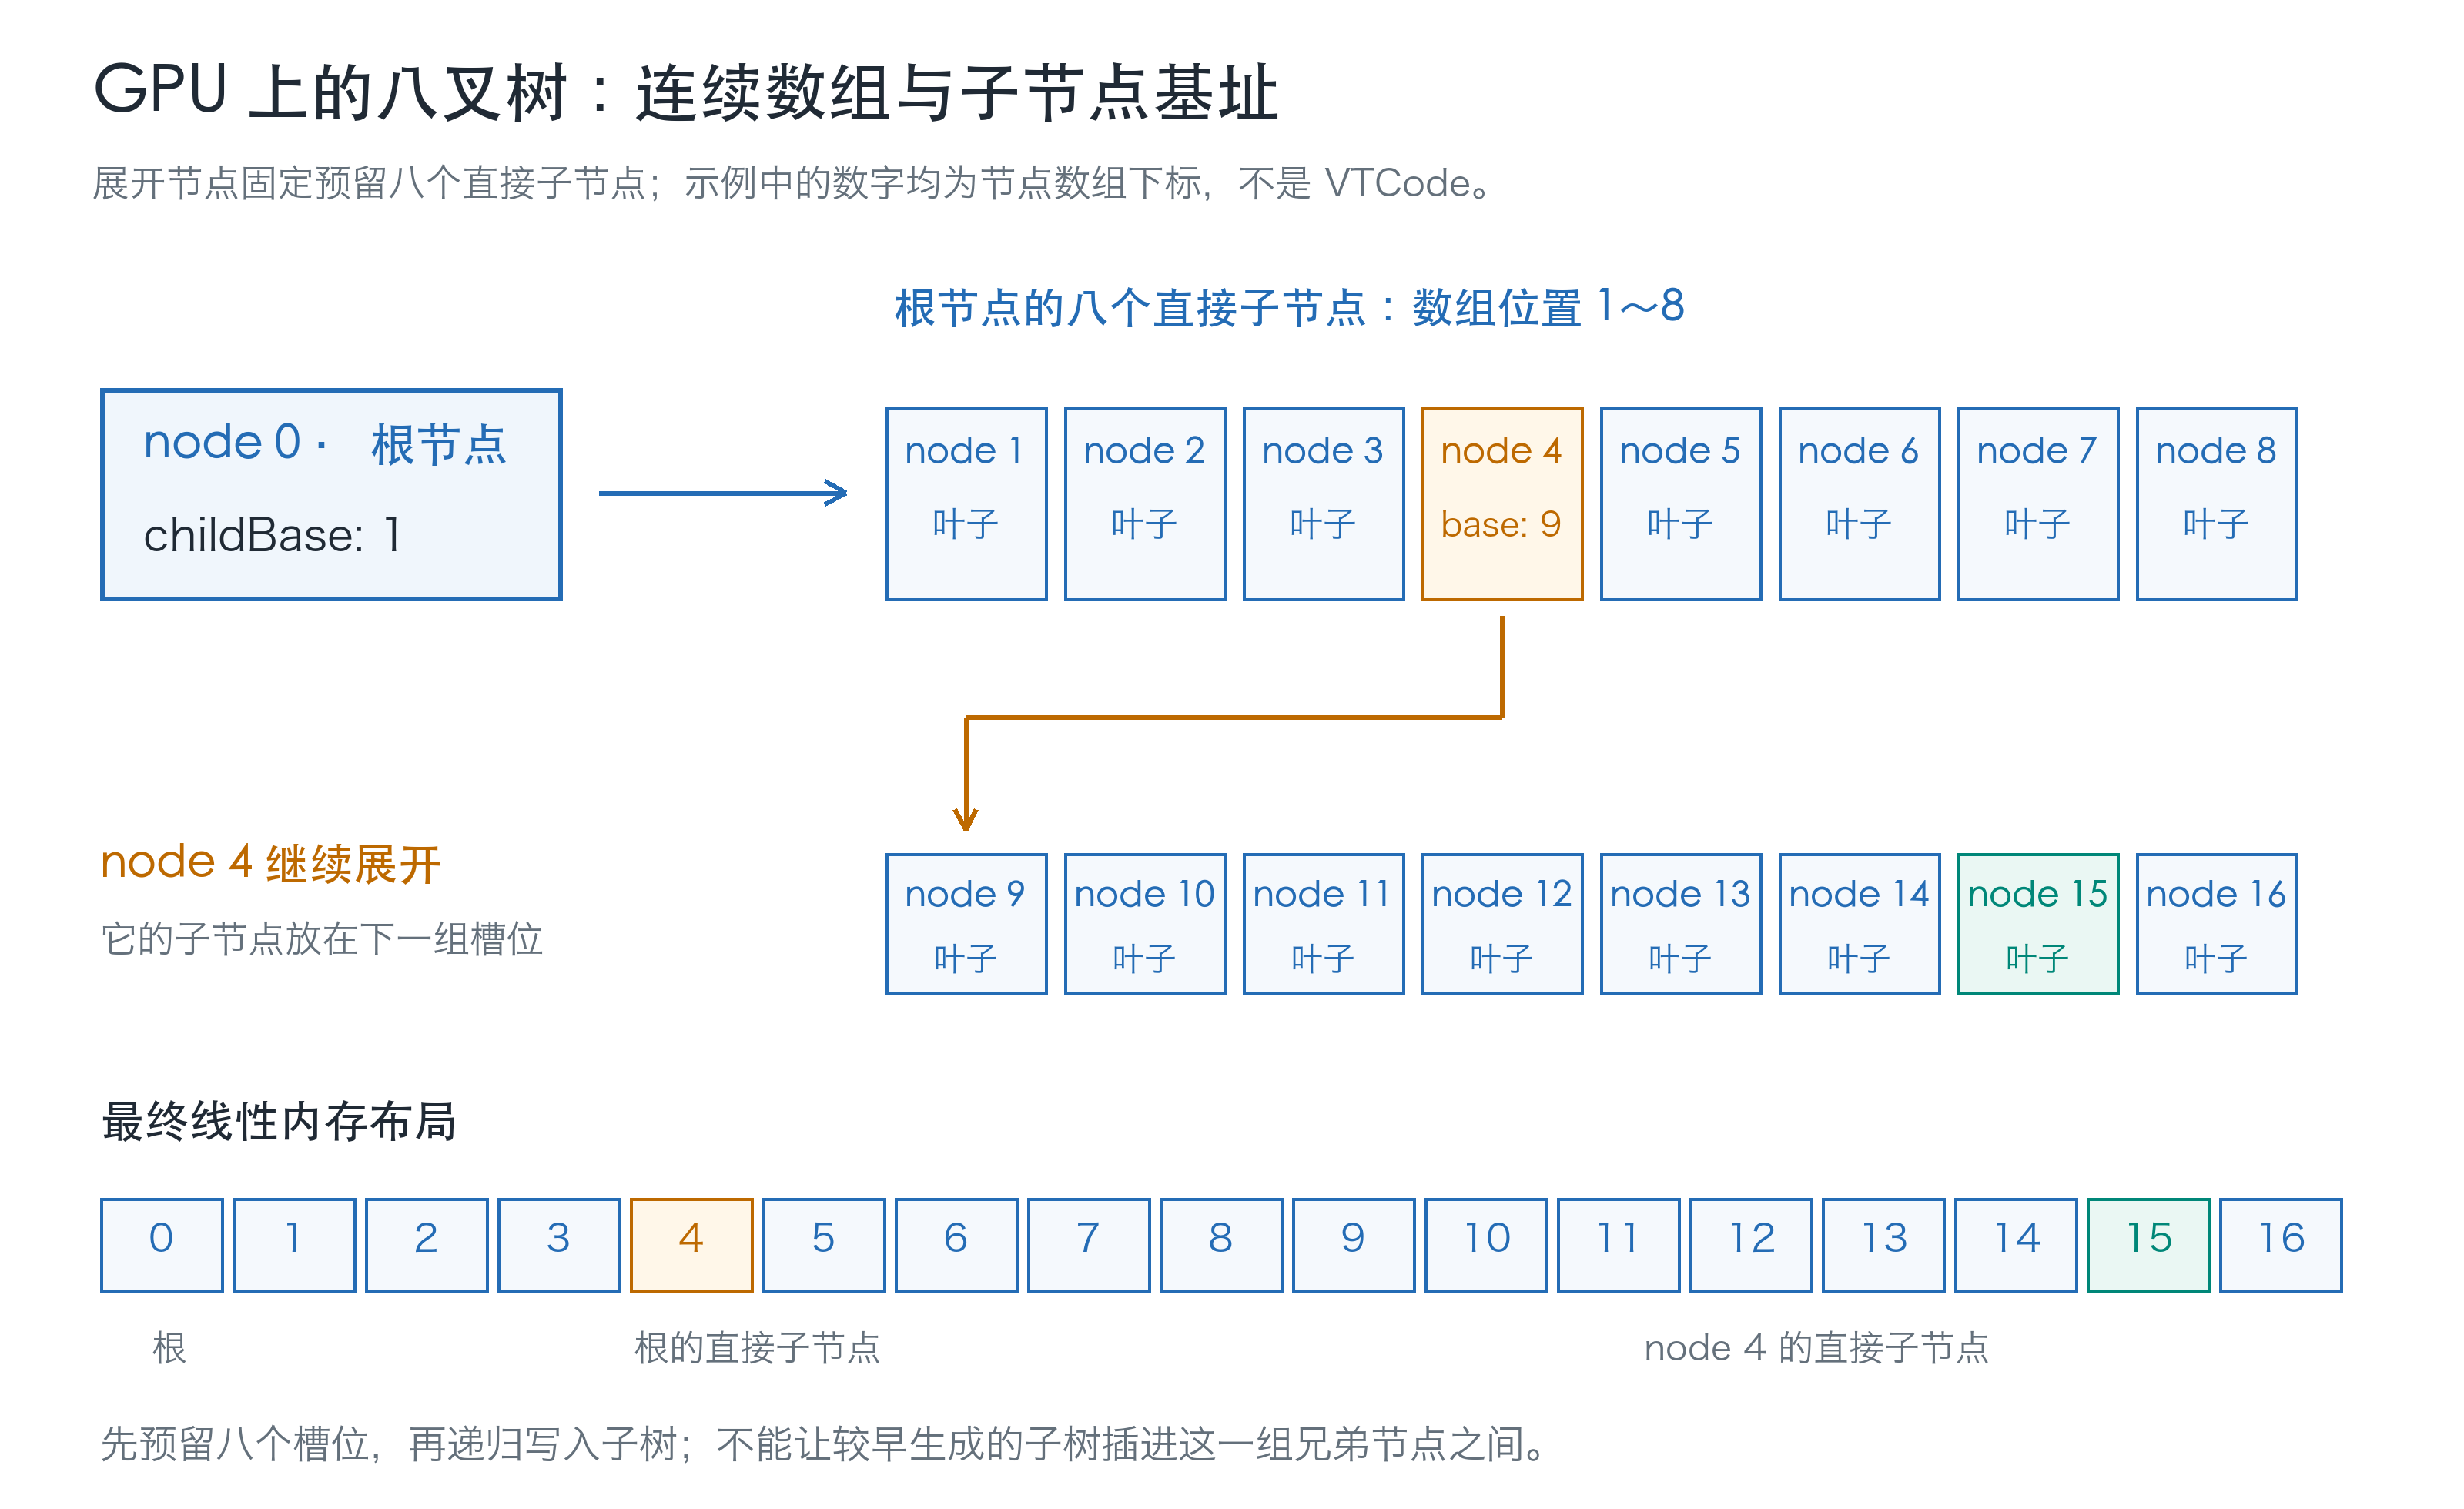
图:根的直接子节点位于1~8;node 4继续展开,其直接子节点位于9~16。
2. 从查询位置逐级定位叶子
设最小体素尺寸为s,分块索引为\mathbf{k},场景最小角点为\mathbf{o}_{\mathrm{scene}}。先计算当前分块原点,再将世界位置\mathbf{p}_w转换到树空间:
b控制沿法线的微小偏移,带几何可见性数据的路径使用b=0.01。它只改变查询位置,不移动已保存的Probe。查询范围为\mathbf{p}_t\in[0,1024)^3,越界时返回失败,不自动切换分块。
遍历从节点0开始。对于当前节点,VTCode解码得到层级L和该层整数坐标\mathbf{q},由此恢复边长d、最小角点\mathbf{m}与中心\mathbf{c}:
比较查询点与中心:各轴处于低半区记为0,高半区记为1,中分面归入高半区。按照X、Z、Y对应bit0、bit1、bit2的约定,下一节点下标为:
对应的核心代码只有三行:
uint3 greater = uint3(step(center, treePos));
uint offset = greater.x | (greater.z << 1u) | (greater.y << 2u);
uint next = leafNode.childBase + offset;
读取下一节点后重复判断,遇到叶子立即返回。它只走一条根到叶子的路径,不搜索其他兄弟节点。最大层级为10时,最多下降十次、检查十一个节点,因此循环上限为 depth <= 10,并在读取前检查数组下标。
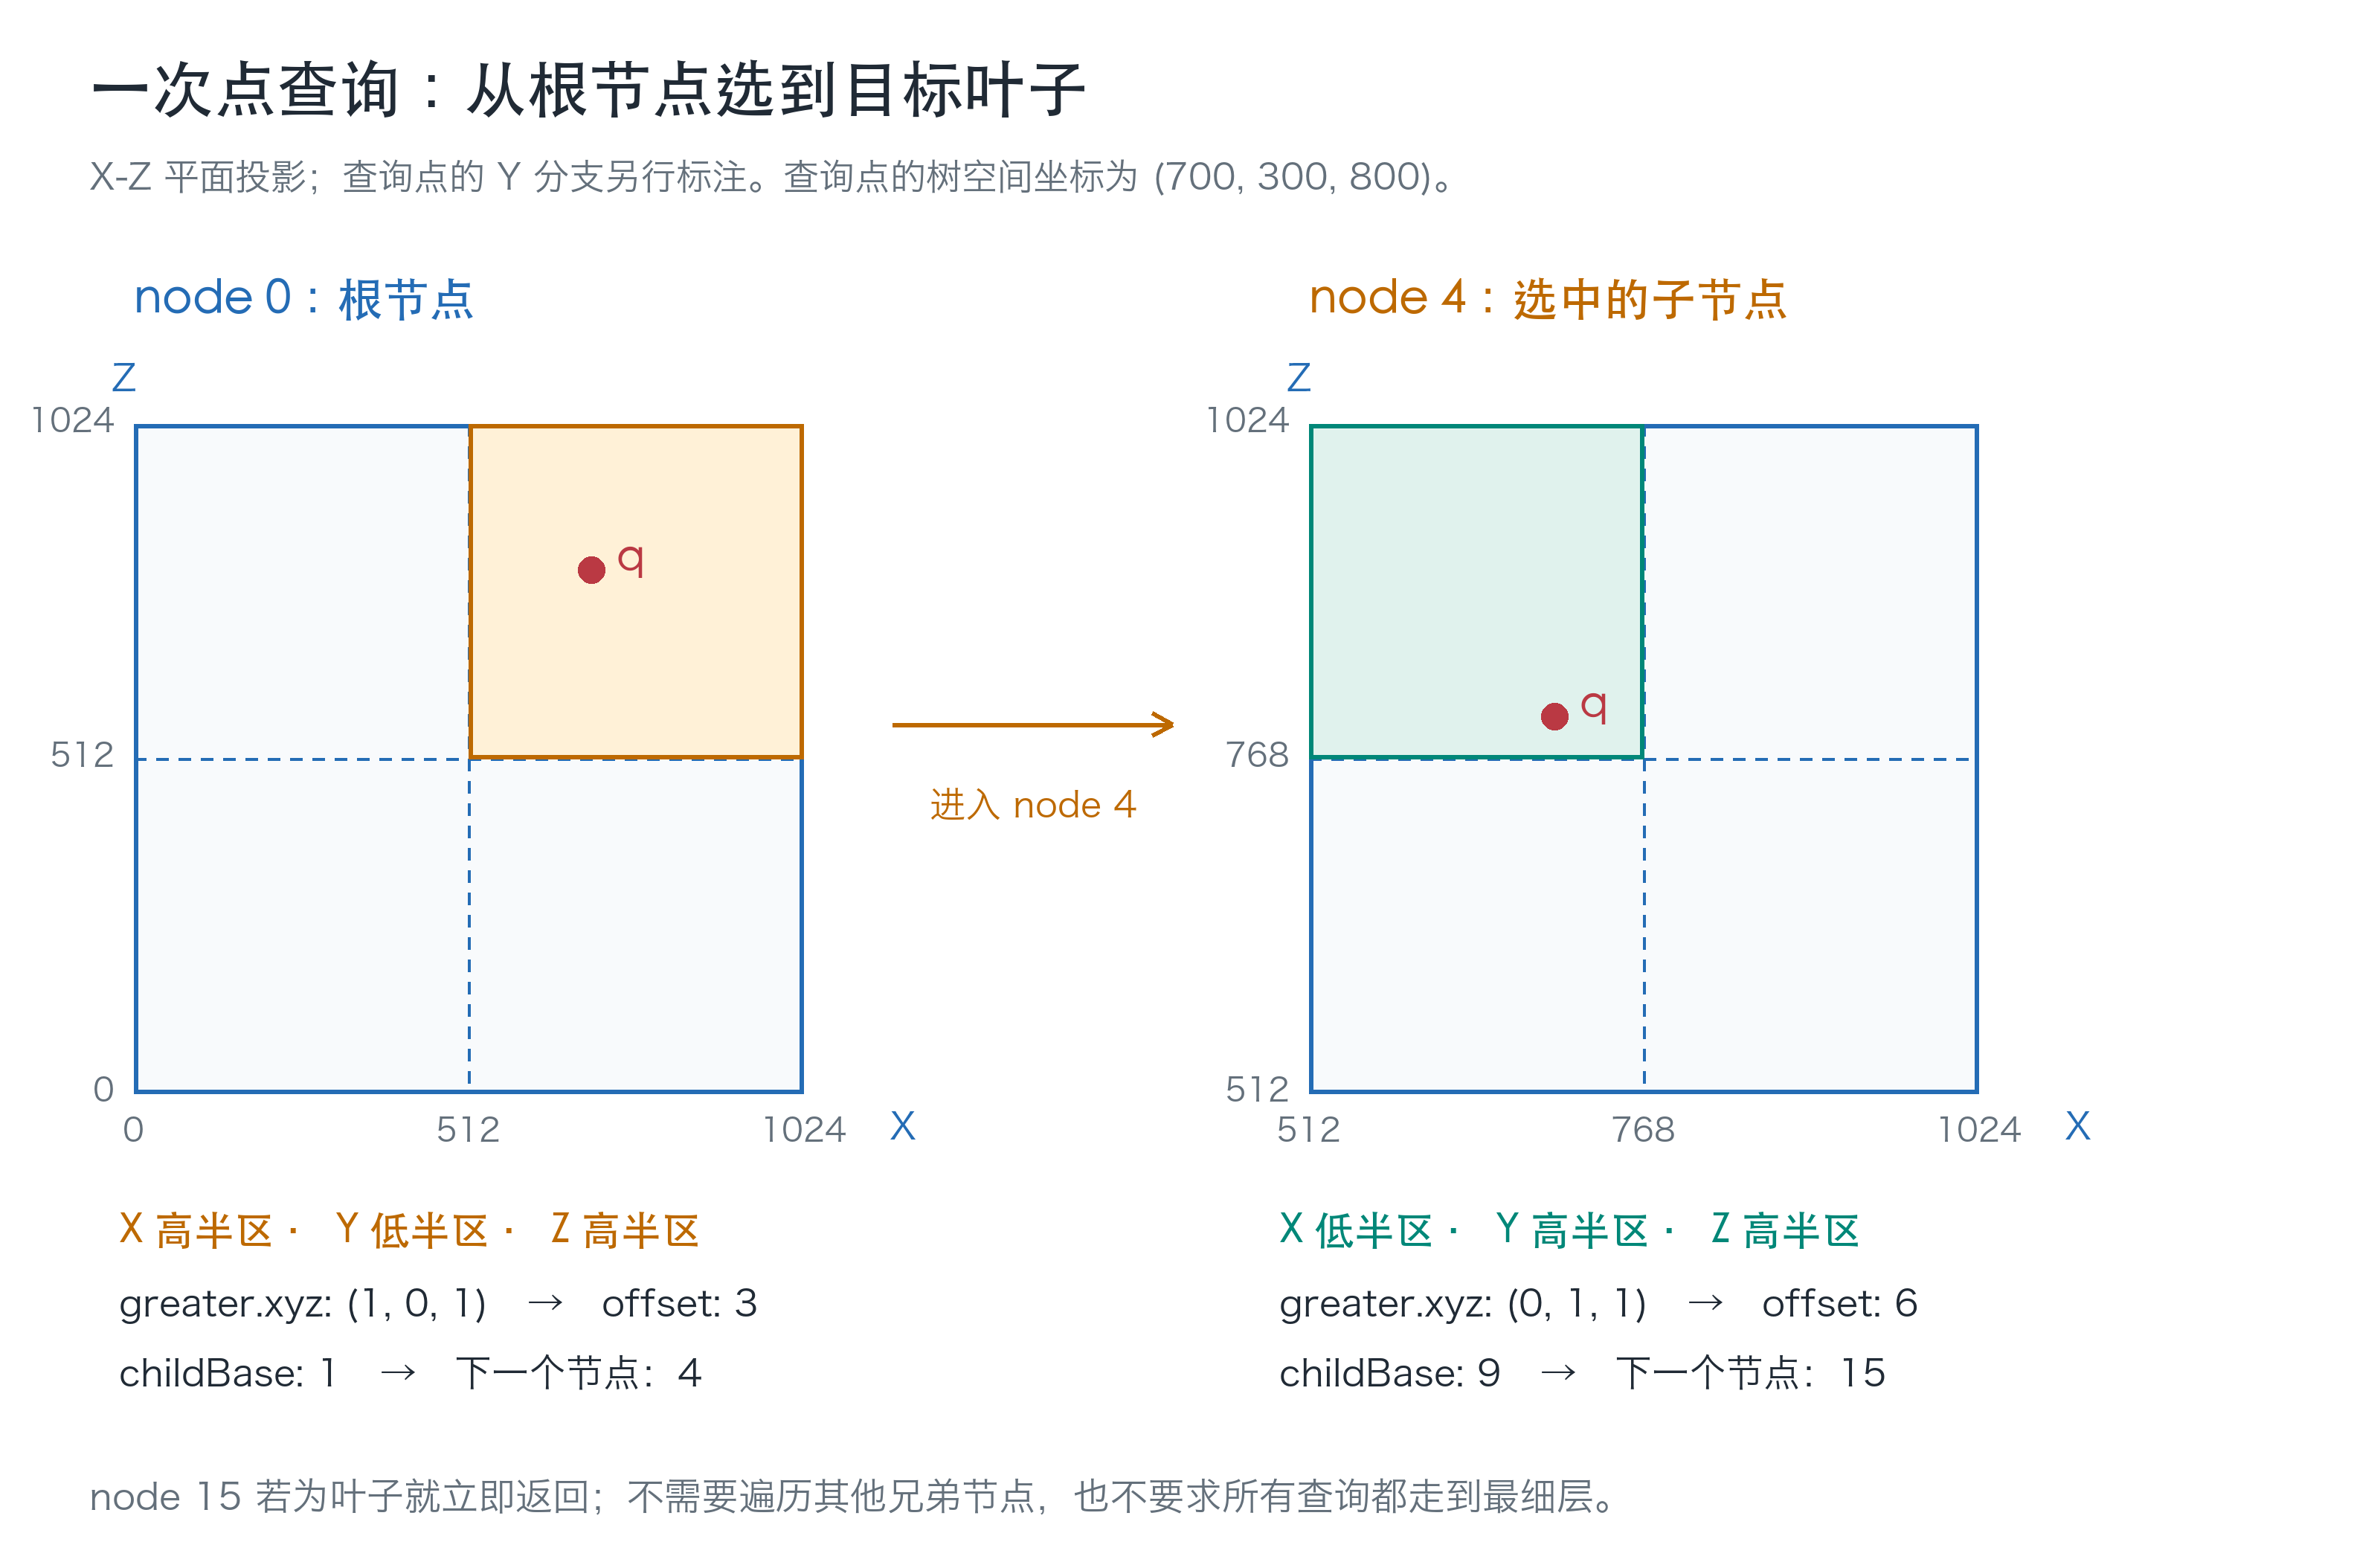
图:查询点(700,300,800)在根节点选择偏移3,进入node 4;下一层选择偏移6,进入node 15。Y轴虽然未画在投影中,仍参与分支计算。
3. 取出Probe引用与采样坐标
叶子的角点索引指向 _probePositions中的实际位置;当前与历史光照分别保存在 _shCoefficients和 _historyShCoefficients。每个Probe拥有九个RGB系数,因此探针p的第k项地址为:
这里的元素类型是 float3,不能再把RGB通道数乘进索引步长。无效角点应先跳过;命中叶子并不保证其角点都有有效光照。
空间插值仍根据逻辑叶子计算局部比例:
自适应叶子的尺寸不同,不能用 frac(treePos)代替该比例。Probe的位置修正也不改变叶子范围:逻辑范围用于寻址和基础插值,实际位置用于方向与可见性计算。
最后,八叉树只负责找到候选Probe,几何BVH才负责判断它们是否被遮挡。 CPU保存、加载时校验节点与探针映射,GPU执行越界和深度保护;这些检查通过后,仍需在光照采样中排除不可见的探针贡献。
屏幕空间GI像素绘制
Relight已经更新了Probe的SH,Composite负责把这些光照应用到屏幕中的物体表面。这里的“屏幕空间”指按可见像素执行:光照仍来自世界空间Probe,不是从屏幕颜色反推GI。 当前Pass在URP后处理之前执行。
1. 找到像素对应的接收表面
Shader读取相机深度,构造符合当前图形API约定的裁剪空间坐标\mathbf{c}_{\mathrm{clip}},通过逆视图投影矩阵恢复世界位置:
天空背景跳过GI计算。表面法线则由相邻像素的位置差重建:分别在水平、竖直方向选择深度更接近当前像素的一侧,再叉乘、归一化并校正朝向,减少跨越物体轮廓时的错误法线。
接收表面的Albedo通过一次额外的不透明物体绘制获得,保存到全分辨率纹理中。当前采集沿用 _BaseMap和 _BaseColor材质约定,不使用已经包含光照的相机颜色代替Albedo。
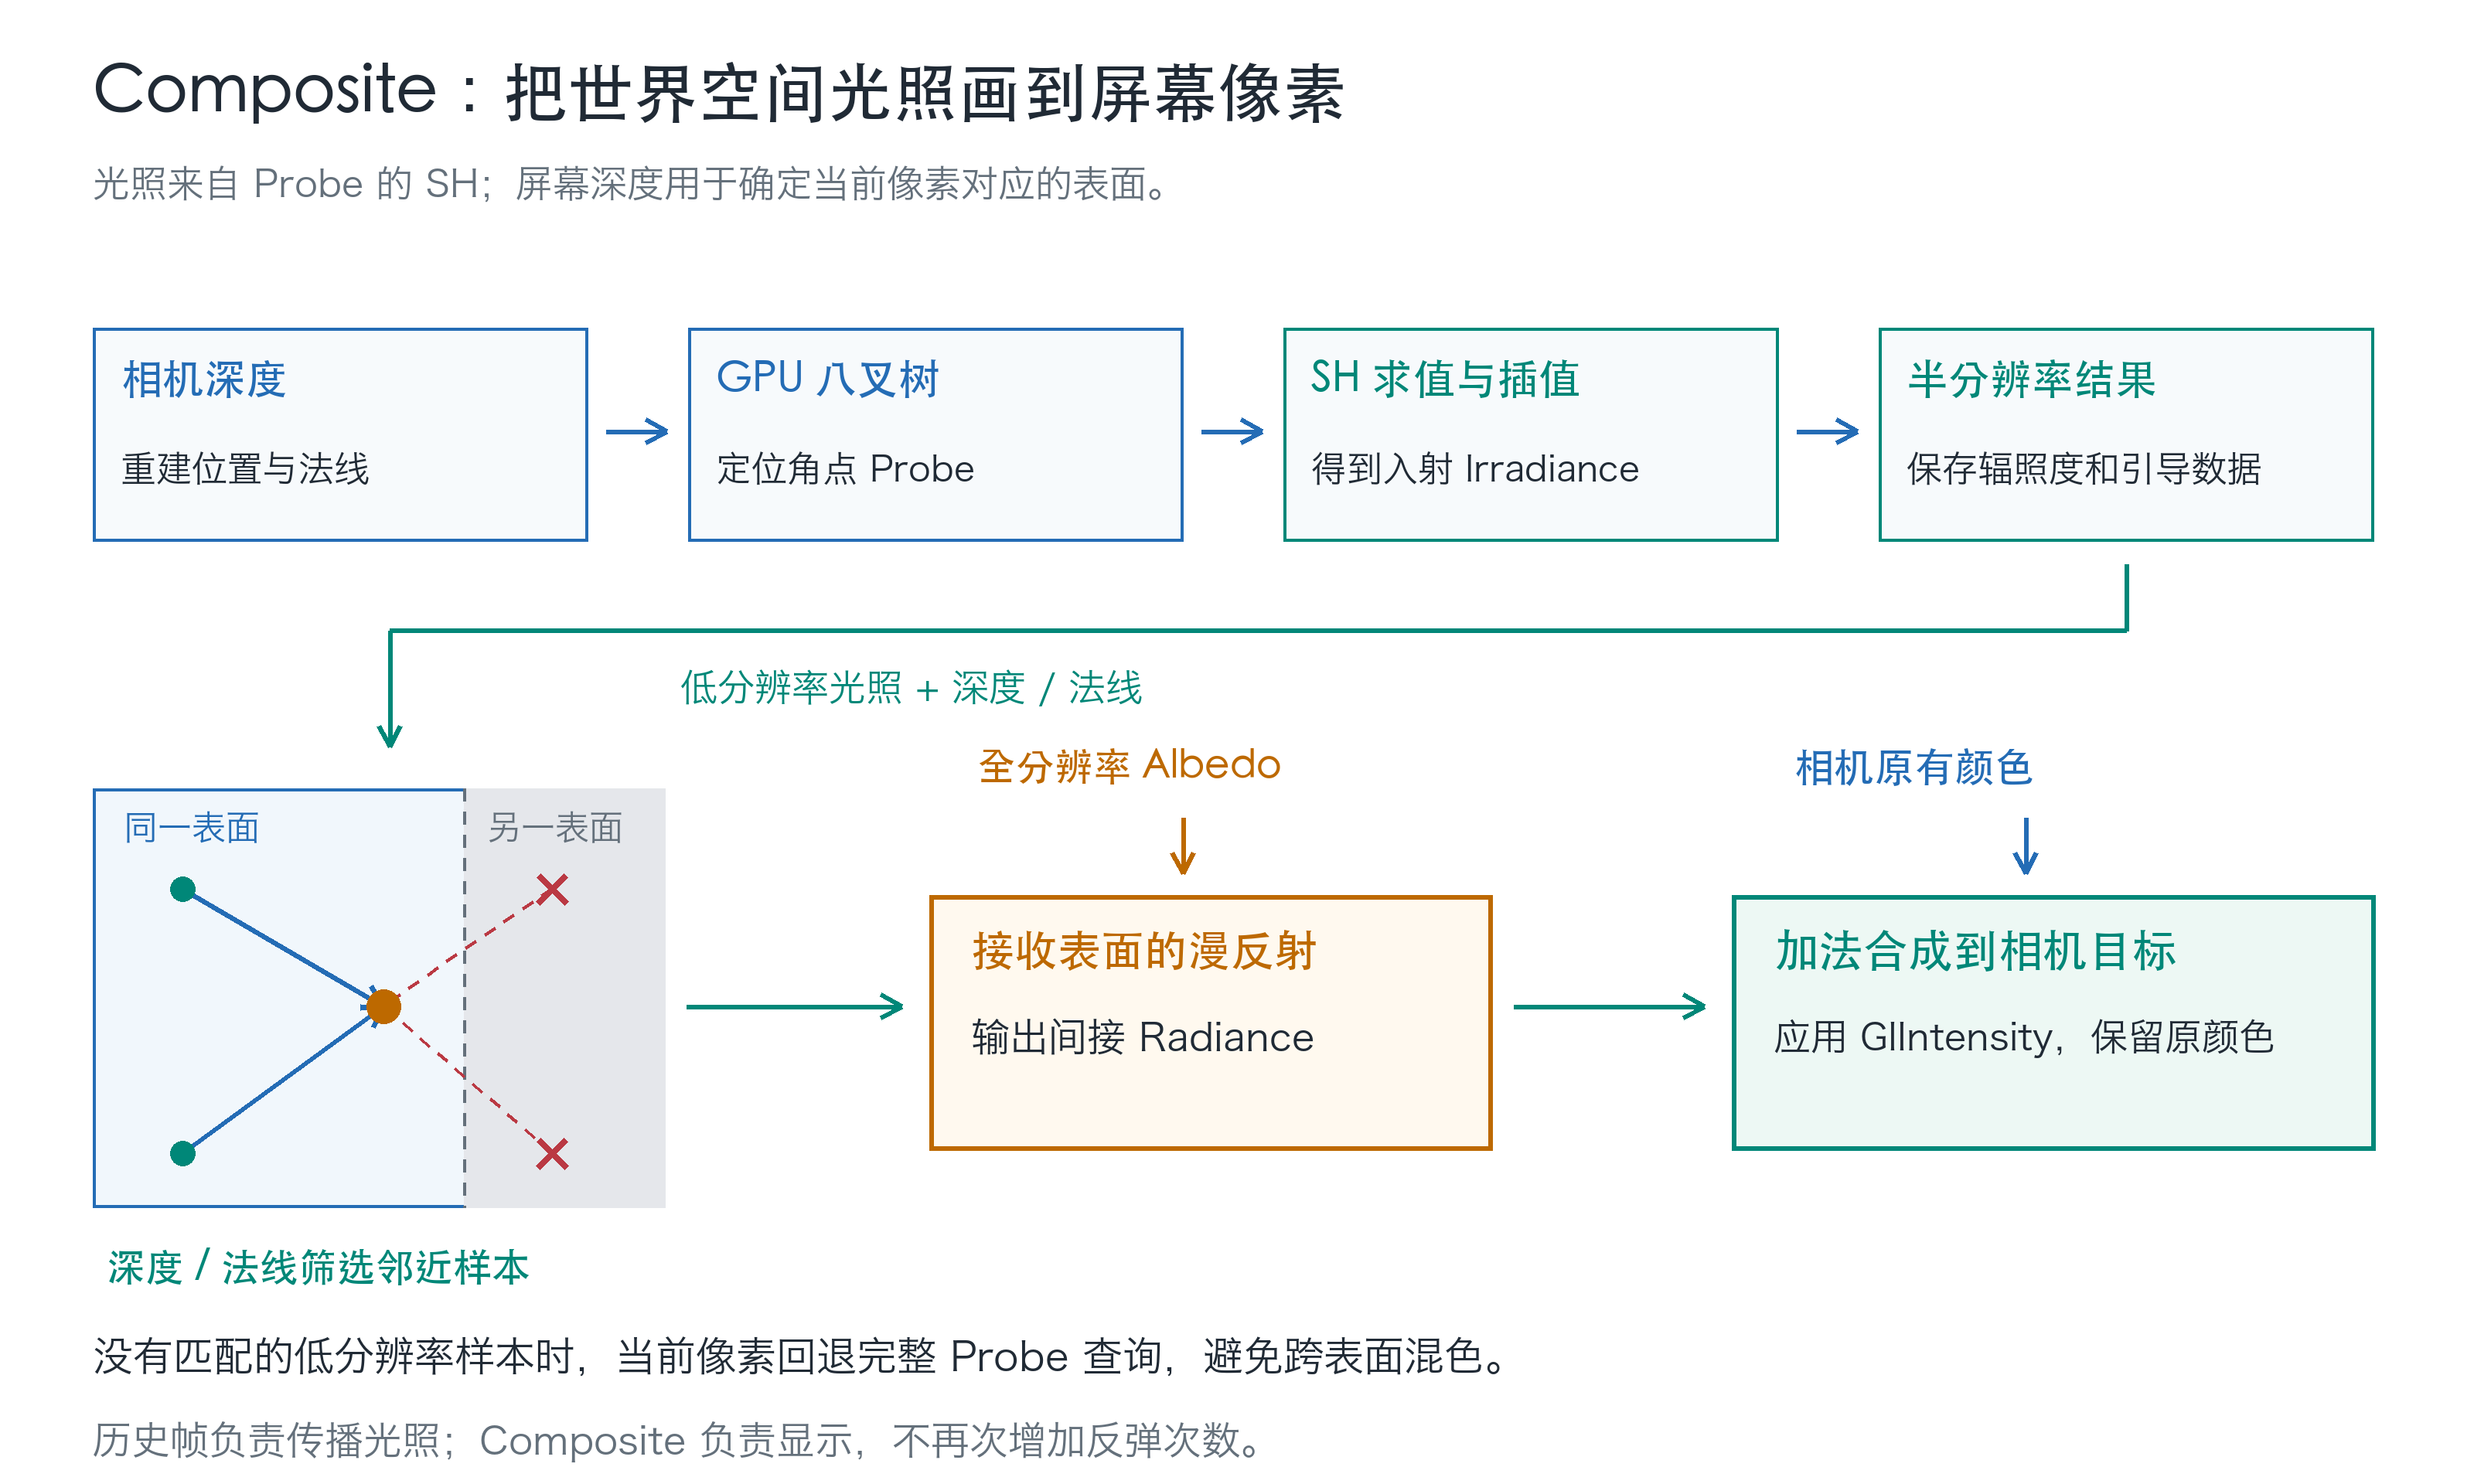
2. 从Probe的SH求出Irradiance
根据世界位置查询八叉树,取得叶子的角点Probe。对第j个有效Probe,沿接收表面法线\hat{\mathbf{n}}计算余弦卷积后的辐照度:
再结合三线性空间权重、法线权重和几何可见性进行归一化插值:
其中\hat{\mathbf{d}}_j指向Probe的实际位置,V_j表示着色点到Probe之间是否无遮挡。无效角点直接跳过;所有贡献都无效时返回零。分子、分母必须使用同一套组合权重,否则会额外压暗结果。
3. 将Irradiance合成为像素颜色
得到Irradiance后,使用接收表面反射率\boldsymbol{\rho}完成漫反射,并叠加到原有相机颜色:
其中I_{\mathrm{GI}}对应 GIIntensity。这里的Albedo属于接收表面,Relight中的Albedo属于反射光的Surfel,两者不是重复计算。基础材质应避免已经包含同一份间接光,以免重复叠加。
以上是逐像素着色的基本过程。流程图中的半分辨率路径、引导上采样以及加法合成的优化实现,放在下一章介绍。
优化策略
运行时需要分别控制两类开销:Relight随本帧更新的Probe及Surfel数量增长,Composite则随屏幕查询像素数增长。 因此,限制探针更新和降低GI计算分辨率解决的是不同问题,需要分别检查耗时。
1. Probe更新优化:距离筛选与每帧预算
只更新相机周围的候选探针
设相机位置为\mathbf{c},探针实际位置为\mathbf{p}_i,更新半径为R。仅将满足以下条件、且已经拥有Surfel数据的探针加入候选集合:
这是一种球形范围筛选,不是视锥或遮挡剔除:相机背后的Probe只要位于范围内,也可以更新,因为它们仍可能参与周围的间接光传播。指定 RenderCamera时以该相机为中心,否则使用当前执行渲染的相机。
| 参数 | 默认值 | 作用 |
|---|---|---|
RelightRadius |
200世界单位 | 控制允许更新的空间范围 |
MaxRelightProbesPerFrame |
1024 | 控制每帧最多更新多少个Probe |
任一参数为0时暂停探针更新,但不清空已有SH。范围外的探针也不会被删除,只是暂时保留上次计算的光照;这不等同于卸载探针数据或实现分块流式加载。
在候选集合中轮询,而不是每帧从头更新
若候选探针超过预算,运行时调度游标会继续向后扫描,选满本帧预算就停止。下一帧从上次结束处继续,避免数组靠前的Probe一直被更新、后面的Probe长期得不到机会。
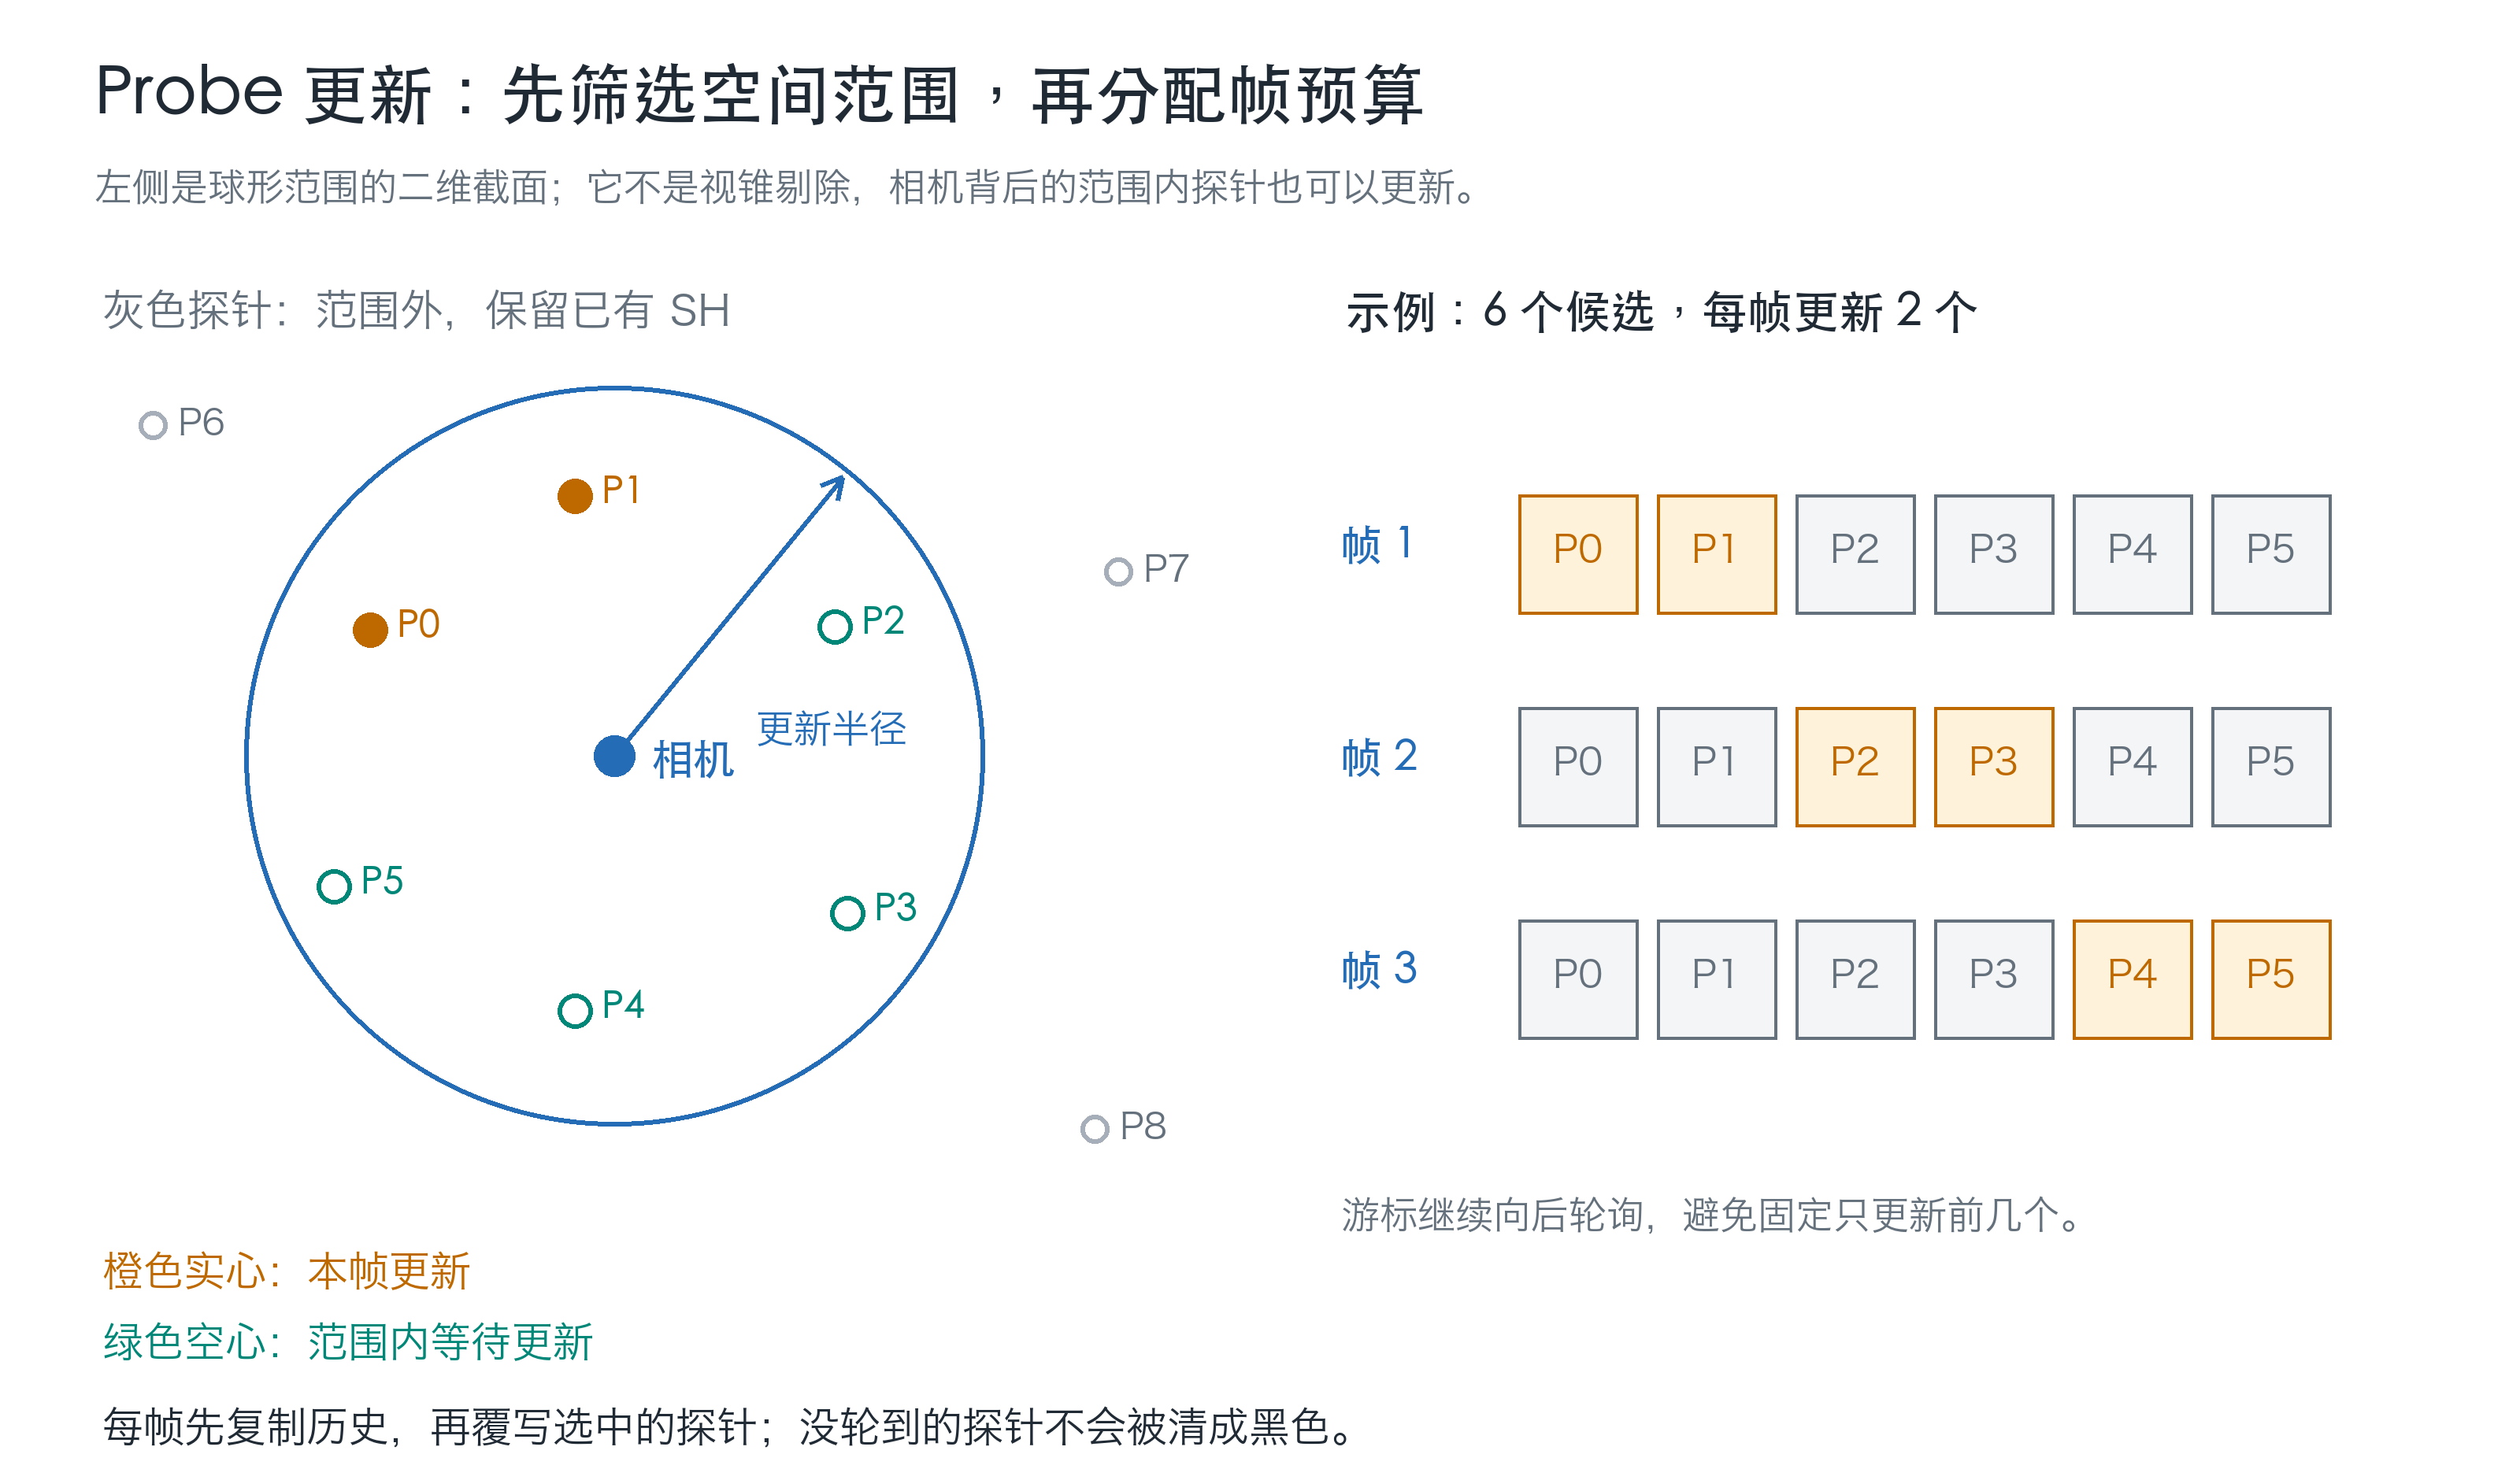
图:示例中有六个范围内候选,每帧更新两个,三帧完成一次轮询;灰色探针保留旧光照。
选中的索引写入 _relightProbeIndices,Compute Shader只为这些探针启动Relight线程组。同一帧的额外相机提交不会再次推进更新,避免突破帧预算。
分帧更新时,SH双缓冲不能简单地交换后只写选中项。当前先由 CopyHistory把全部历史系数复制到输出,再覆写选中的Probe,保证未更新项仍然有效。这个复制操作仍有开销,但不需要重新处理它们的Surfel。
若候选集合固定,有K个探针、每帧预算为M>0,一次刷新大约需要\lceil K/M\rceil帧。增大半径会扩大候选集合,在预算不变时可能拉长刷新周期;预算过小则会使灯光变化和多次反弹收敛变慢。首次加载或重置后,尚未轮到的探针仍为零,需要预热时间。
2. 半分辨率计算与最终合成
减少查询次数,而不是把算完的图再缩小
Composite中昂贵的步骤是八叉树定位、角点Probe读取、BVH可见性检查和SH求值。如果先在全分辨率完成这些计算,再缩小纹理,并不能节省这部分开销。
当前直接在低分辨率目标上执行它们。对于尺寸为W\times H的视口,低分辨率尺寸为:
例如,偶数尺寸下每个低分辨率像素对应一个2\times2的全分辨率像素区域,主体GI查询数量约降至四分之一。
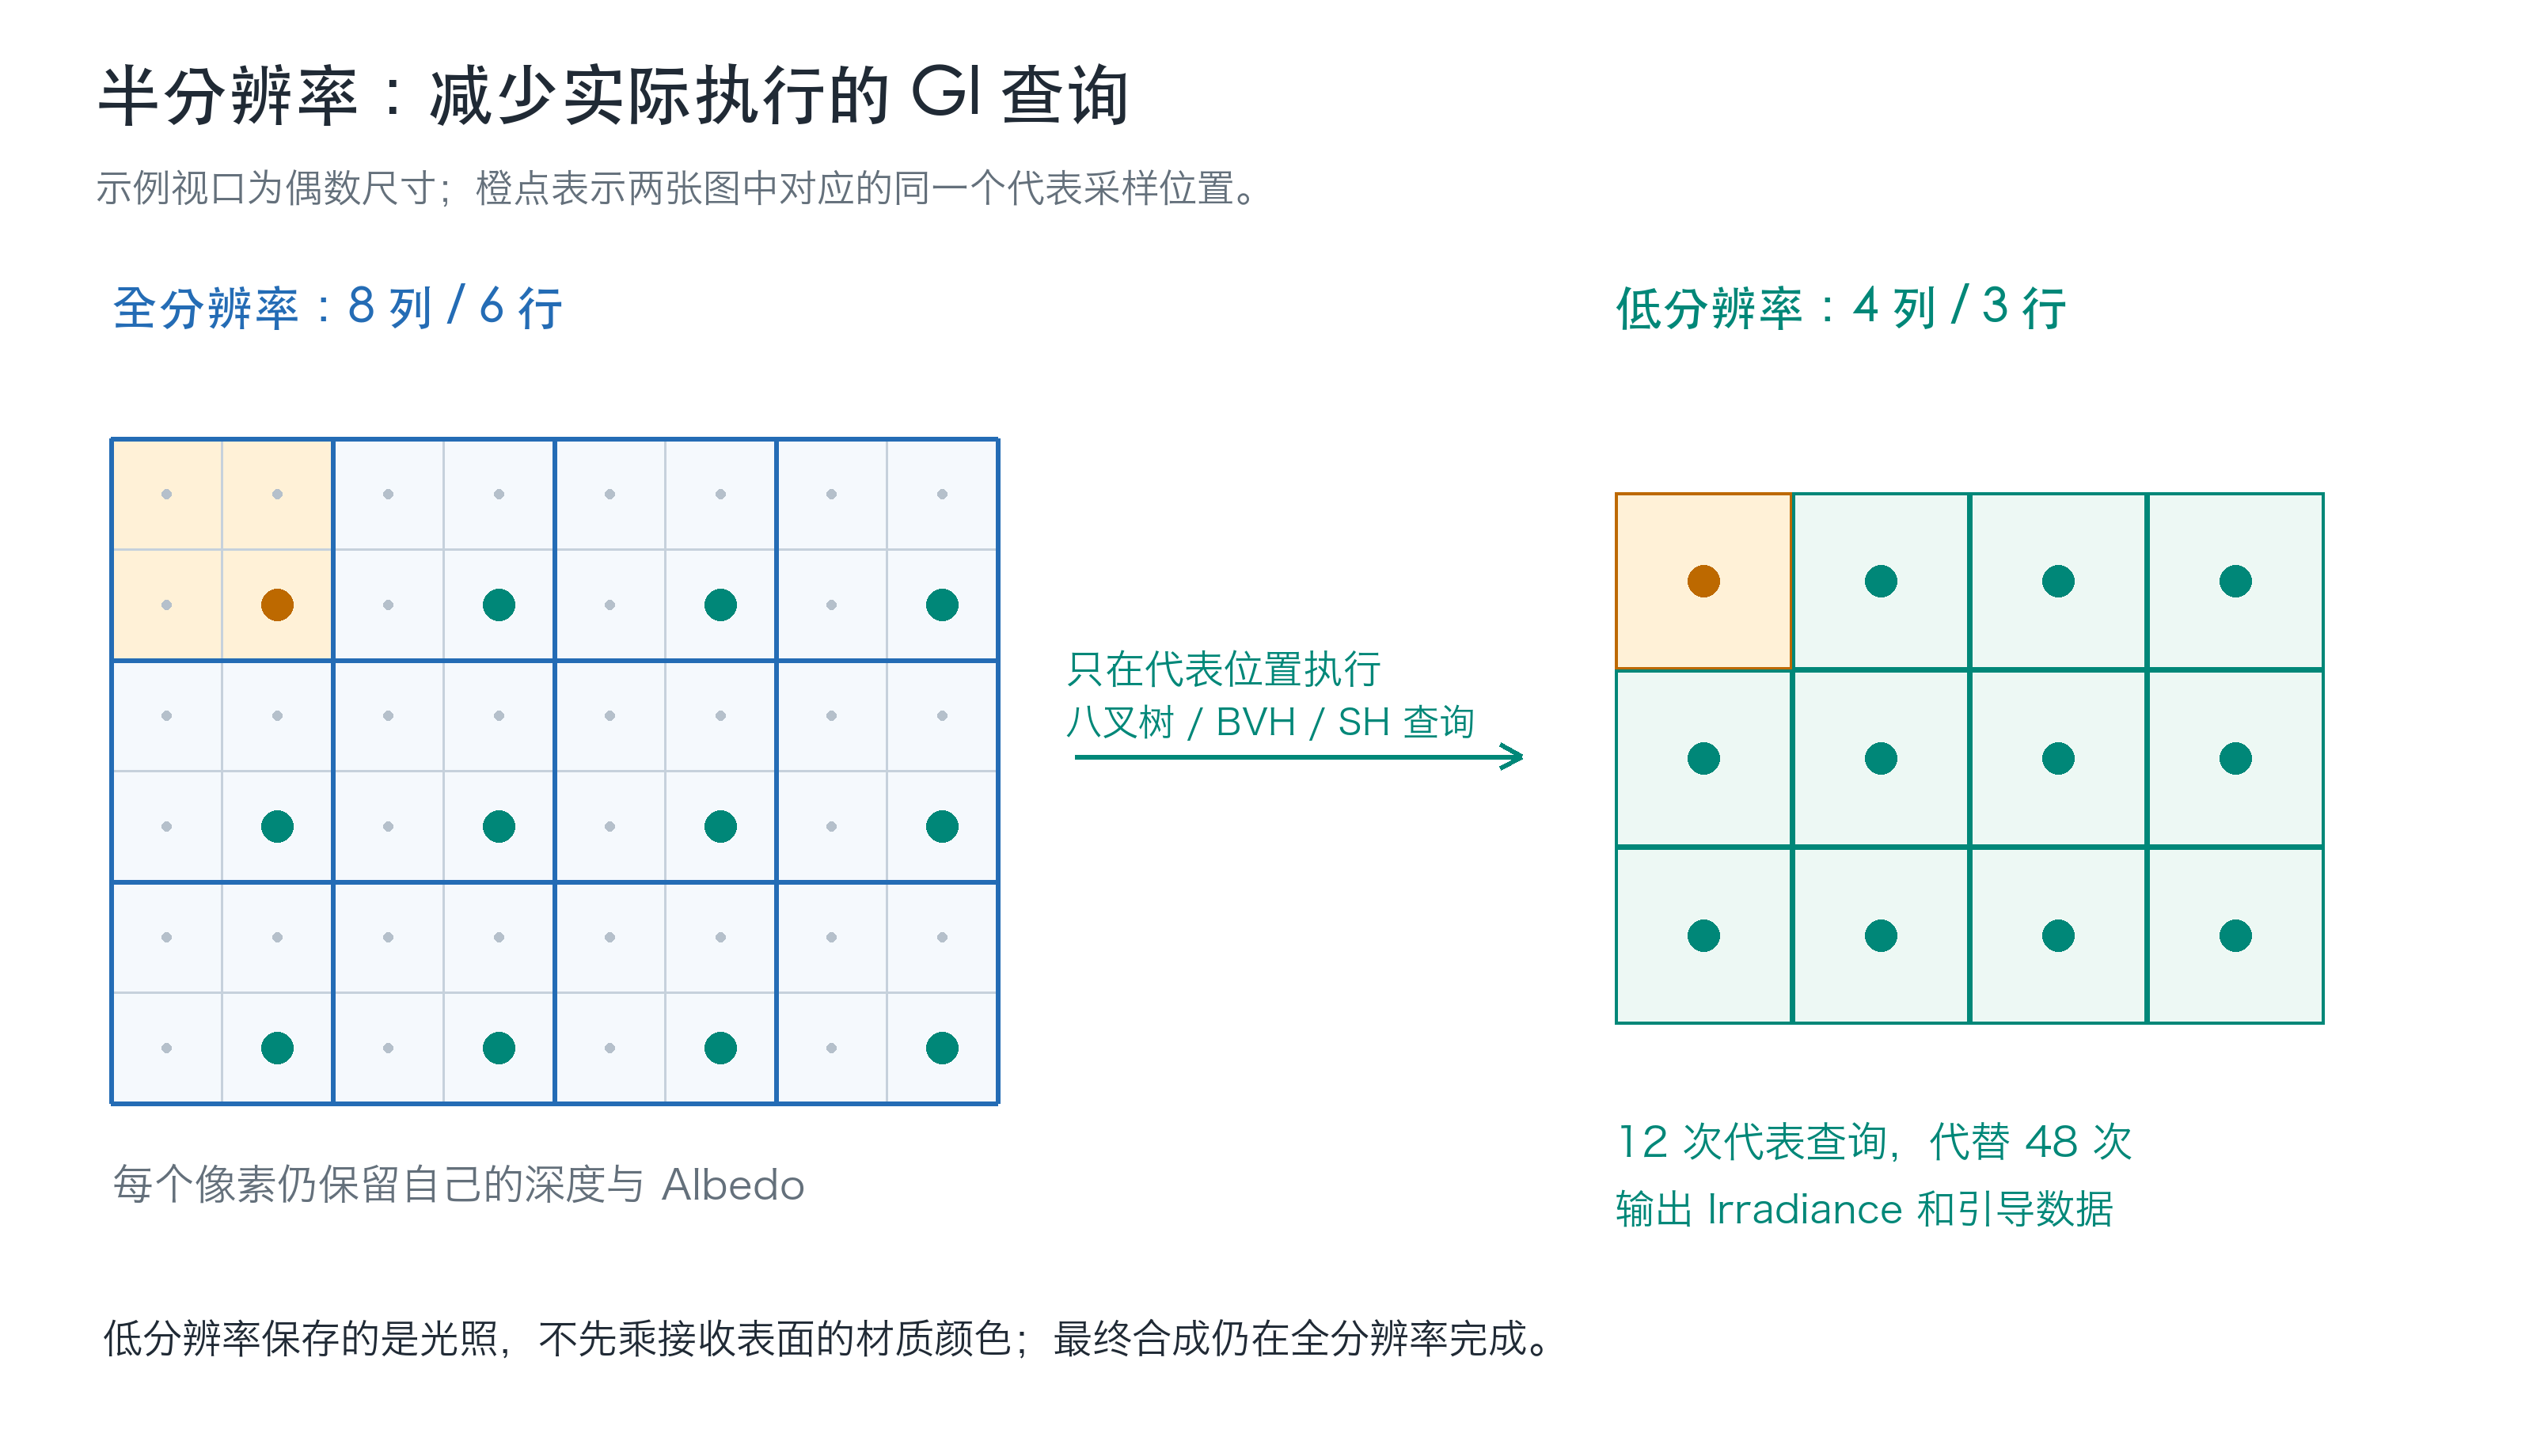
图:48个全分辨率像素先由12个代表位置完成光照查询,其余像素通过后续重建获得结果。
低分辨率阶段通过两个渲染目标同时输出:
| 纹理 | 内容 | 格式 |
|---|---|---|
_PRTLowIrradiance |
未乘接收表面Albedo的RGB辐照度 | ARGBHalf |
_PRTLowGuide |
RGB保存世界法线,Alpha保存原始设备深度 | ARGBFloat |
相机深度输入、接收表面的Albedo和最终颜色目标仍保持全分辨率。引导数据用于判断哪些低分辨率样本适合当前表面,而不是直接作为颜色显示。
固定代表像素,保证采样与重建对齐
以X轴为例,低分辨率像素的整数索引为j_x,对应的全分辨率代表像素索引及其中心UV为:
Y轴采用相同规则。偶数尺寸时,这相当于选取每个2\times2区域右下像素的中心;奇数尺寸的末端则钳制到最后一个有效像素。
上采样时,对全分辨率像素中心UV的X分量u,按当前实现计算低分辨率连续坐标:
对两个轴分别取整与小数部分,即可选出四个邻近低分辨率样本,并计算双线性空间权重;邻域索引需要钳制到纹理的有效范围。还原样本世界位置时,必须再次使用同一套代表像素映射。否则,深度来自一个像素、UV却来自相邻像素,会把原本匹配的表面误判为不匹配,造成大量回退。
用法线和表面距离筛选四邻域
直接双线性放大会跨越物体边界:一个像素可能混入背景、墙后物体或侧面的光照。当前实现先读取目标像素的世界位置\mathbf{p}和法线\hat{\mathbf{n}},再用Guide恢复每个低分辨率样本的位置\mathbf{p}_j和法线\hat{\mathbf{n}}_j。
背景样本直接排除,其余样本需满足法线与局部表面平面的匹配条件:
d_j衡量样本到当前像素切平面的距离,而不是两个点的欧氏距离。这样,同一斜面上的邻点即使相机深度不同,也不必被错误排除。当前容差随视空间深度的绝对值z_{\mathrm{eye}}和像素尺寸变化:
其中s为 MinVoxelSize。设\alpha_j为双线性空间权重,\chi_j表示样本是否通过筛选,则最终权重和重建结果为:
最后这个除法只在有效权重足够时执行。它既避免跨表面混色,也防止因剔除部分样本而把结果无故压暗。
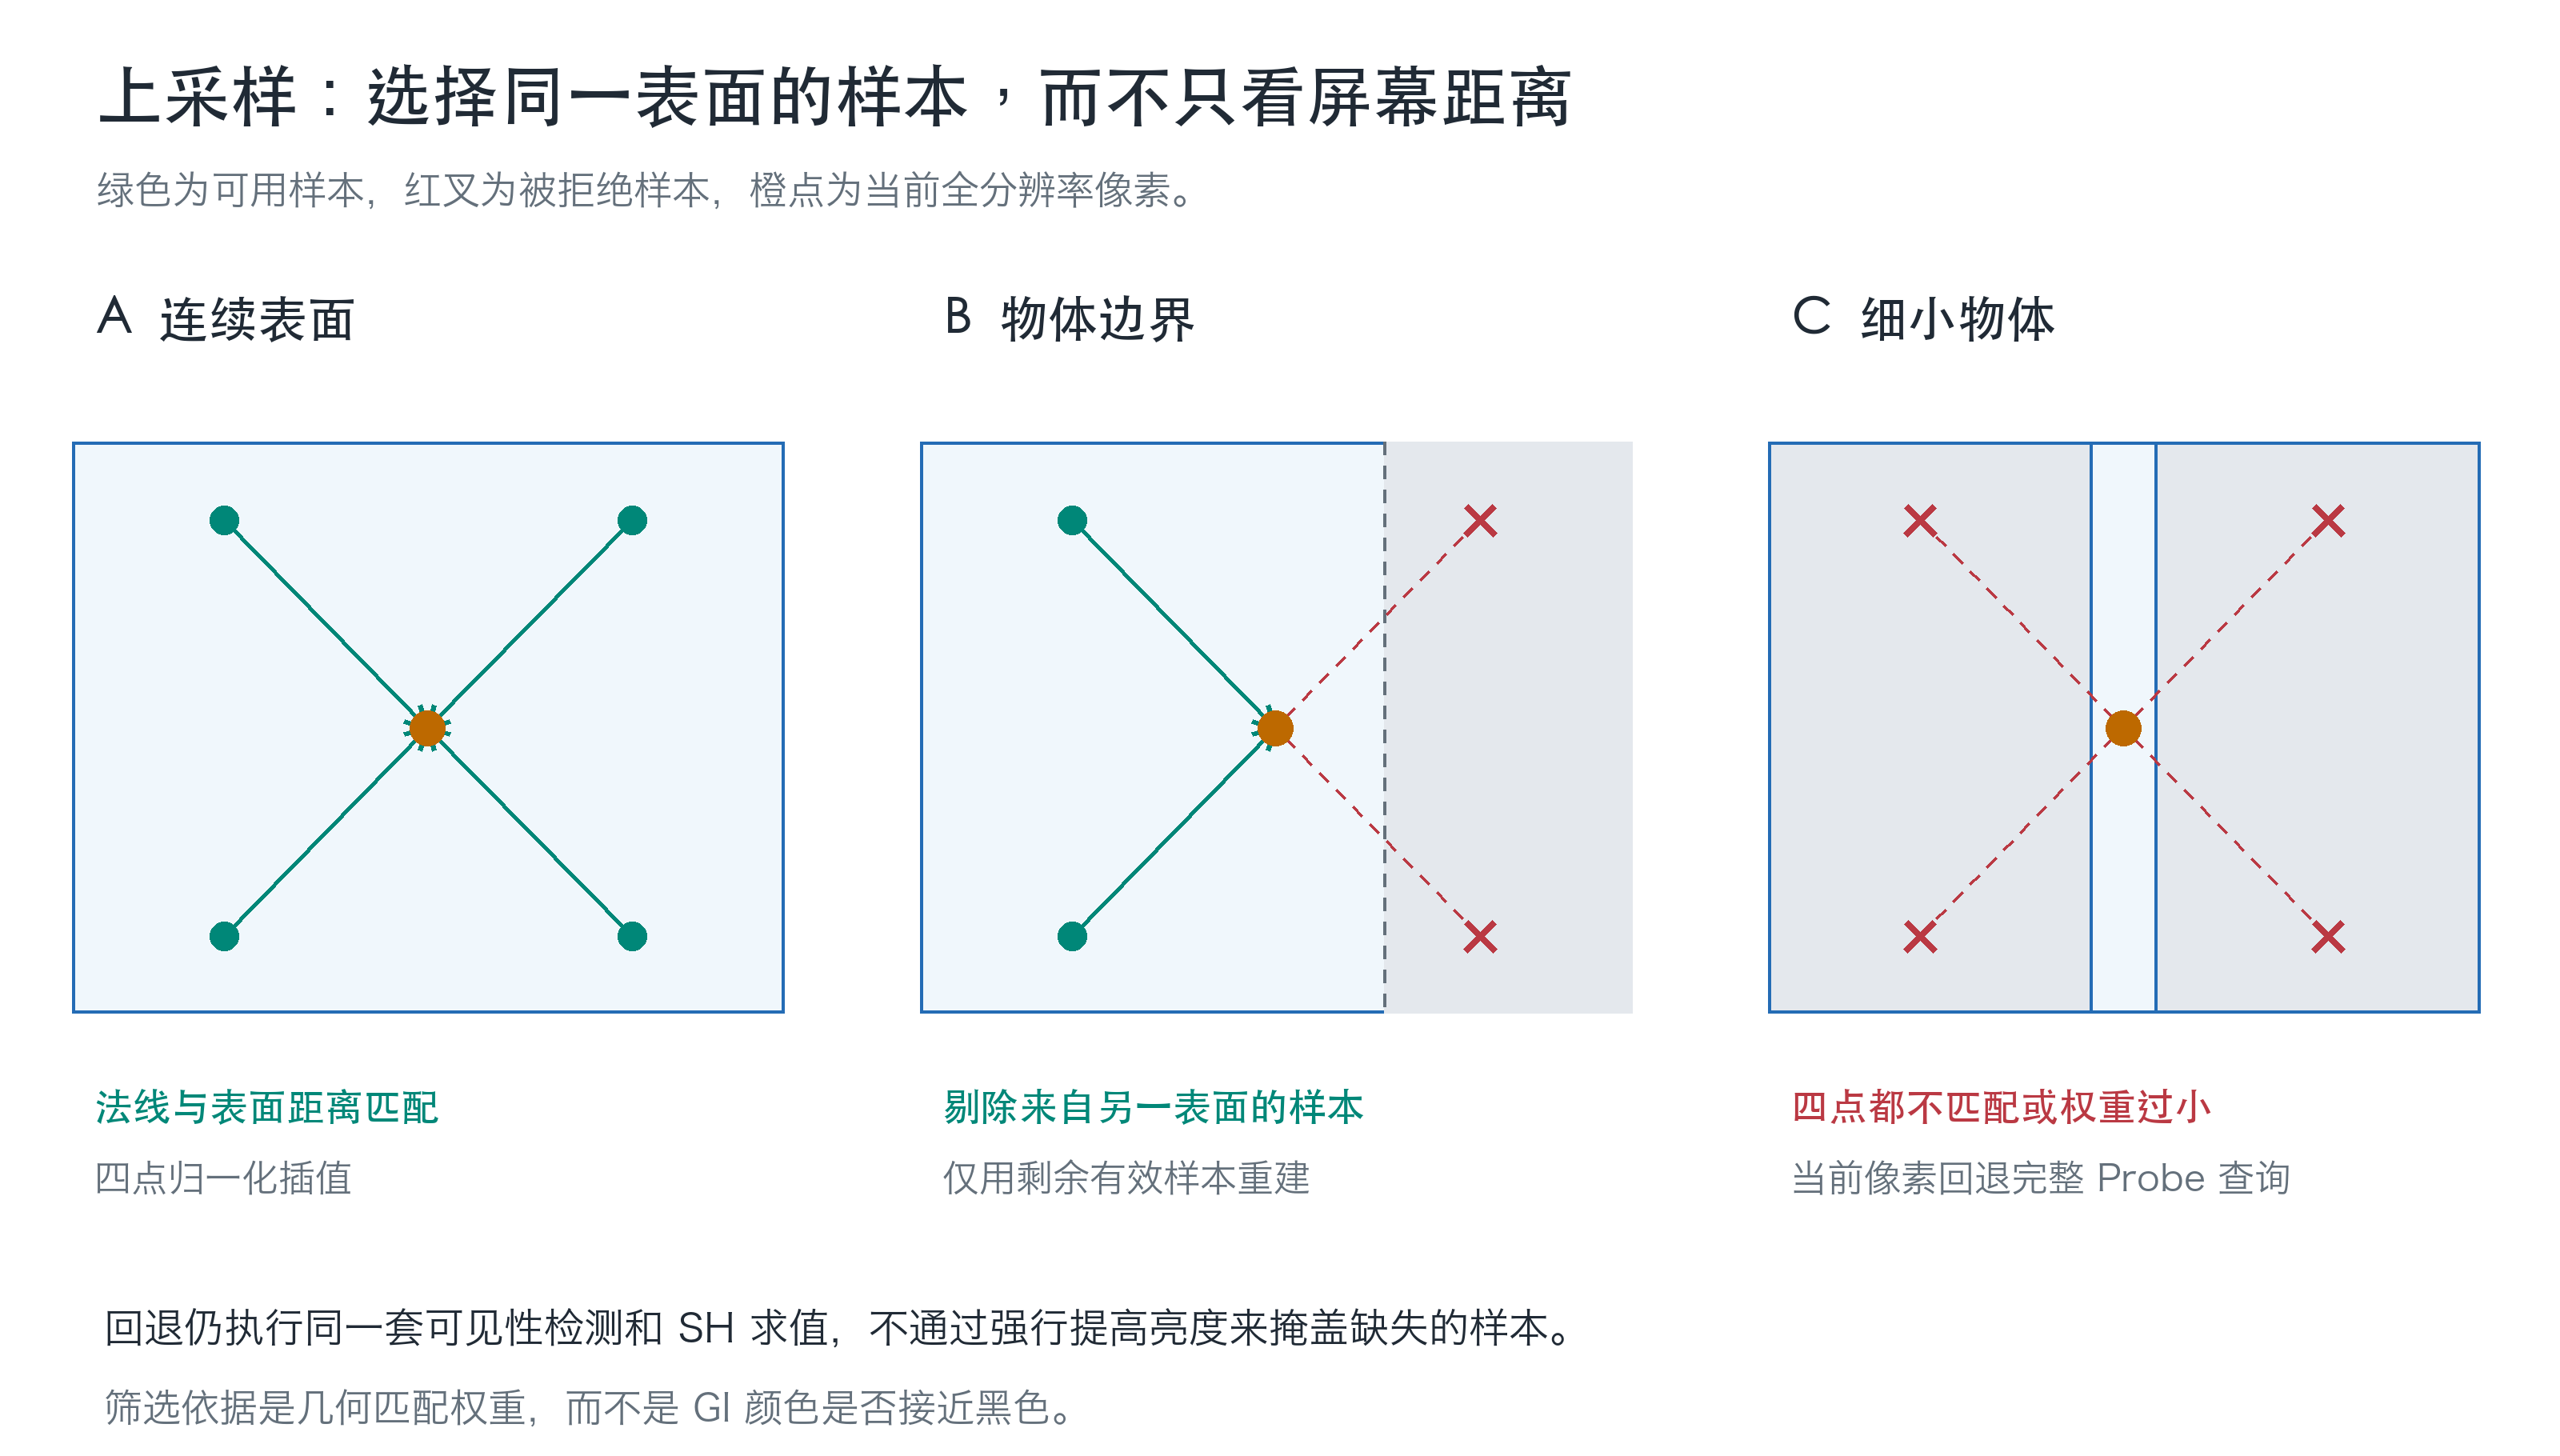
没有匹配样本时,回退完整查询
细小物体可能没有被任何代表像素覆盖。若四个邻域样本都被排除,或总权重不大于10^{-5},Shader就从当前全分辨率像素的位置执行完整Probe查询。
回退依据是几何匹配权重,而不是GI颜色是否很暗。 正常阴影或无有效Probe贡献得到的零值,不能通过借用其他表面的亮光来修补。回退提高了边界处的可靠性,也会增加查询开销;细碎几何越多,半分辨率的收益可能越小。
在全分辨率应用材质并完成合成
重建得到Irradiance后,才使用当前全分辨率像素的Albedo,按前章的漫反射公式转换为间接Radiance。这样低分辨率纹理不会预先混入红墙、白色方块等不同材质颜色,材质边界仍由全分辨率数据决定。
正常模式使用加法混合直接叠加到相机颜色目标,只写RGB并保留原有颜色与Alpha。因此不需要为了合成再复制整张相机颜色、计算后回拷,减少了全屏带宽开销。
这项优化不会降低Probe的空间密度,也不减少历史反弹次数,但光照的屏幕重建仍是近似。对细小物体、凹角和近距离平行表面,应切换 GI Resolution的Full/Half进行对照。DebugMode=3查看纯GI,7查看有效探针贡献;Half模式下,8查看上采样回退:绿色表示复用低分辨率样本,红色表示执行完整查询。
性能检查时分别观察 PRT Albedo、PRT GI Evaluate Half和 PRT GI Upsample。主体查询数减少约75%,不意味着帧率必然提升四倍:全分辨率Albedo、上采样、边界回退和场景其他Pass仍有成本。
最终效果
以下GIF由实际运行录屏转换,用于展示光照变化。

缺陷与不足
1. 方案非主流,Probe分布不够合理
这套基于VTCode稀疏八叉树布置Probe的实现,属于个人实验性的非主流方案,并不是经过充分验证的工程实践。当前分布主要由几何细分和位置修正规则决定,局部过密与关键区域覆盖不足的问题仍然存在。为了修补黑缝和漏光,又引入了更多细分与可见性检测,增加了数据量和实现复杂度。
2. 缺少基于视锥的更新筛选
目前只按相机距离和每帧数量上限轮询,没有结合视锥筛选或优先更新可见区域,暂不可见的探针仍会占用预算。后续应引入可见性优先级,同时为视锥边缘及参与间接光传播的外围探针保留低频更新,避免简单停更导致光照滞后。
3. Composite成本过高,当前实现难以落地
Composite仍需在像素端遍历八叉树、读取多个Probe并进行BVH遮挡查询,分支和不规则访存较多。半分辨率虽然缓解了压力,但以当前实现的成本与效果,这套GPU八叉树查询方案还不具备实际项目落地条件。
均匀格子可以直接计算探针索引,省去逐级遍历,结构也更简单。在本例中,它也许比这套稀疏方案更合算。后续应先在相同画质和显存预算下对比均匀网格,再判断八叉树带来的空间节省是否值得这些额外开销。